

За новым названием GPT‑5.6 стоит не одна универсальная модель, а линейка для разных уровней сложности. OpenAI разделила ее на Sol, Terra и Luna. Такая схема выглядит понятнее прежней гонки названий: сначала команда определяет цену ошибки и объем работы, затем выбирает модель и режим рассуждений.
Важно не сводить релиз к фразе «модель стала умнее». GPT‑5.6 рассчитана на процессы, где нужно удерживать длинный контекст, пользоваться инструментами, проверять промежуточные результаты и доводить задачу до готового артефакта. Это может быть код, аналитический документ, таблица, презентация или серия действий в подключенных сервисах.
Коротко: что изменилось
Sol остается флагманом для дорогих по ошибке задач. Terra занимает середину линейки и рассчитана на регулярную работу команд. Luna делает ставку на скорость и стоимость, поэтому подходит для массовых сценариев, где важны предсказуемые операции, а не максимальная глубина анализа.
Новая линейка добавляет более гибкий выбор уровня рассуждений. В сложных случаях модель может тратить больше времени на проверку гипотез и альтернатив. Для особенно тяжелых задач OpenAI описывает режим ultra: он координирует несколько параллельных агентов и собирает их работу в единый результат.
Для пользователя это означает практическую вещь: не нужно выбирать между «дешево» и «умно» на уровне всей системы. В одном рабочем процессе можно поручить Terra массовую подготовку материалов, а Sol оставить для финальной проверки, сложной логики или вопросов, где ошибка дорого обходится.
Sol, Terra и Luna: кому подходит каждая модель
Sol нужна там, где вопрос нельзя решить хорошим первым черновиком. Это исследование с несколькими источниками, сложная задача в репозитории, подготовка презентации по заданному шаблону или многоступенчатая работа с инструментами. Старшая модель имеет смысл, когда требуется не только ответ, но и проверяемый итог с меньшим числом ручных доработок.
Terra выглядит наиболее разумной отправной точкой для повседневных задач. Она подойдет для разбора рабочих документов, аналитики, подготовки черновиков, классификации входящих данных и сценариев, в которых модель вызывается часто. Если качество Terra уже покрывает требования команды, переход на Sol не всегда даст окупаемый результат.
Luna ориентирована на скорость и экономику. Это не «облегченная версия для всего», а отдельный слой для большого потока предсказуемых действий: первичной сортировки, извлечения полей, кратких пояснений, подготовки вариантов текста и простых агентных шагов. При работе с Luna особенно важно заранее определить, где проходит граница между допустимым черновиком и задачей, которую нужно отправить старшей модели.
Правильная логика выбора начинается не с названия модели. Сначала стоит разложить процесс на этапы, оценить стоимость ошибки и понять, сколько ручной проверки остается после ответа. Модель, которая экономит несколько секунд, но регулярно создает скрытые ошибки, редко оказывается действительно дешевой.
Что показывают независимые сравнения
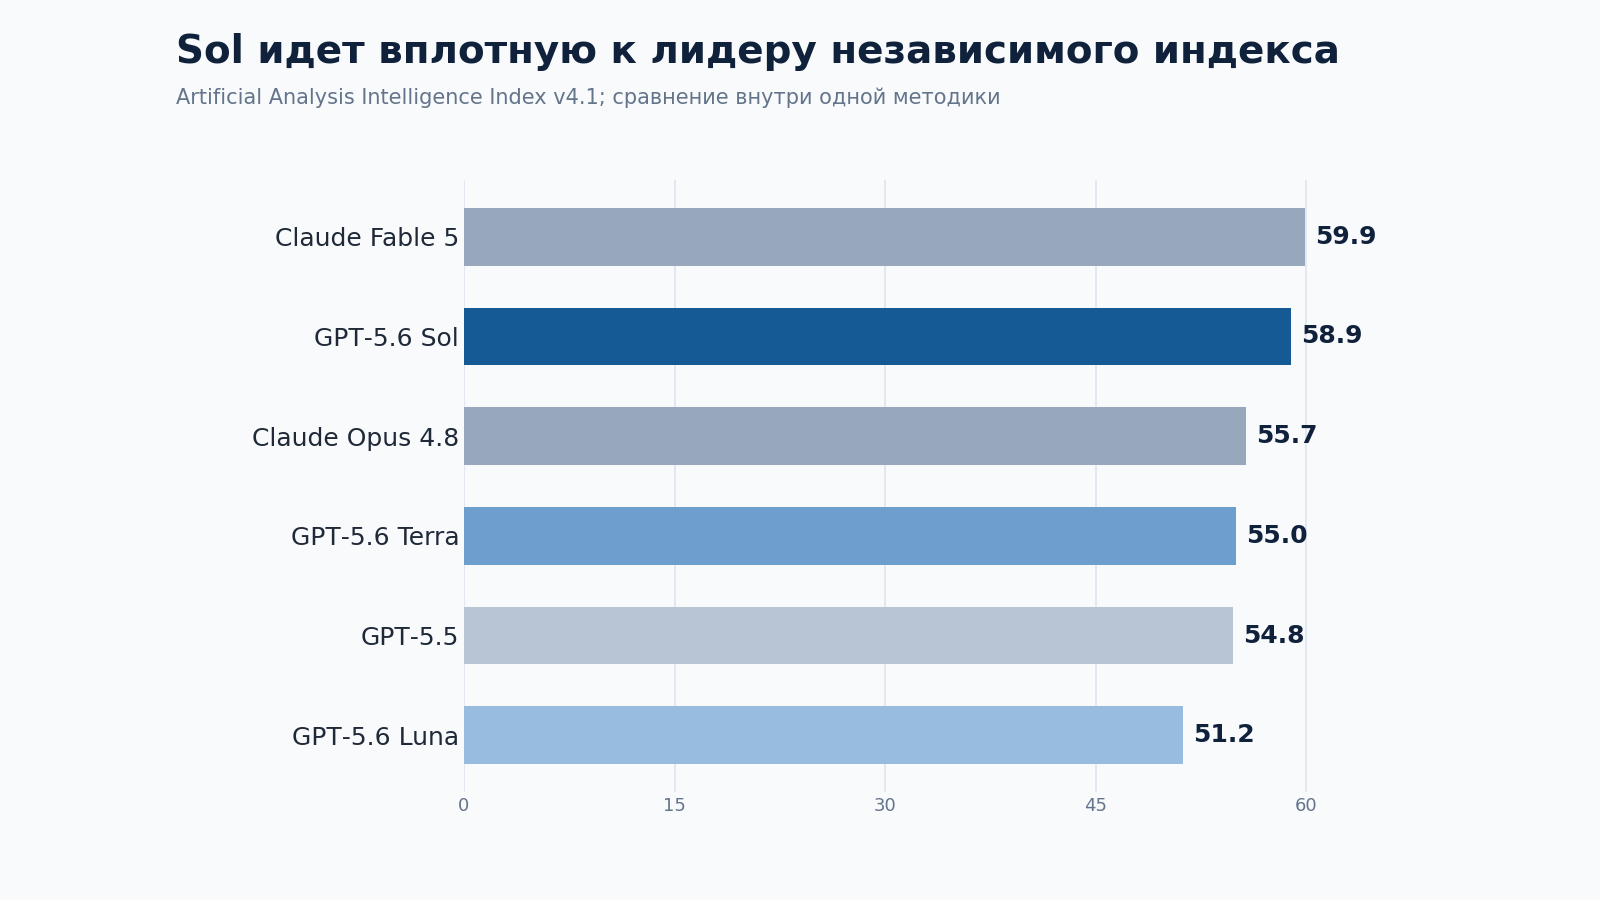
По данным Artificial Analysis, GPT‑5.6 Sol набрала 58,9 балла в Intelligence Index v4.1. Лидер сравнения Claude Fable 5 получил 59,9, а GPT‑5.5 остановилась на 54,8. На верхней границе рейтинга модели идут плотной группой, поэтому разница в одну или две единицы не отвечает на вопрос, какая из них лучше для конкретной команды.
Ценность такого индекса в другом. Он помогает увидеть, что Sol держится рядом с сильнейшими моделями в общем наборе агентных, научных, кодовых и аналитических задач. Terra и Luna показывают более низкий итоговый балл, но дают другой баланс стоимости, скорости и качества. Это полезный ориентир для короткого списка кандидатов, а не готовая закупочная рекомендация.
Artificial Analysis также указывает стоимость тестовой задачи внутри своей методики: для Sol это около 1,04 доллара, для Terra около 0,55 доллара, для Luna около 0,21 доллара. Эти цифры нельзя переносить в финансовую модель компании один к одному. Реальная стоимость зависит от длины контекста, количества повторных шагов, настроек рассуждений, объема ответа и числа подключенных инструментов.
Еще одно ограничение важно проговаривать прямо. Artificial Analysis сообщает, что участвовала в предрелизной оценке моделей OpenAI. Это не отменяет ценность бенчмарка, но требует смотреть на методику, дату теста и конкретный режим, а не превращать одну цифру в абсолютный вердикт рынка.
Почему GPT‑5.6 заметна в задачах программирования
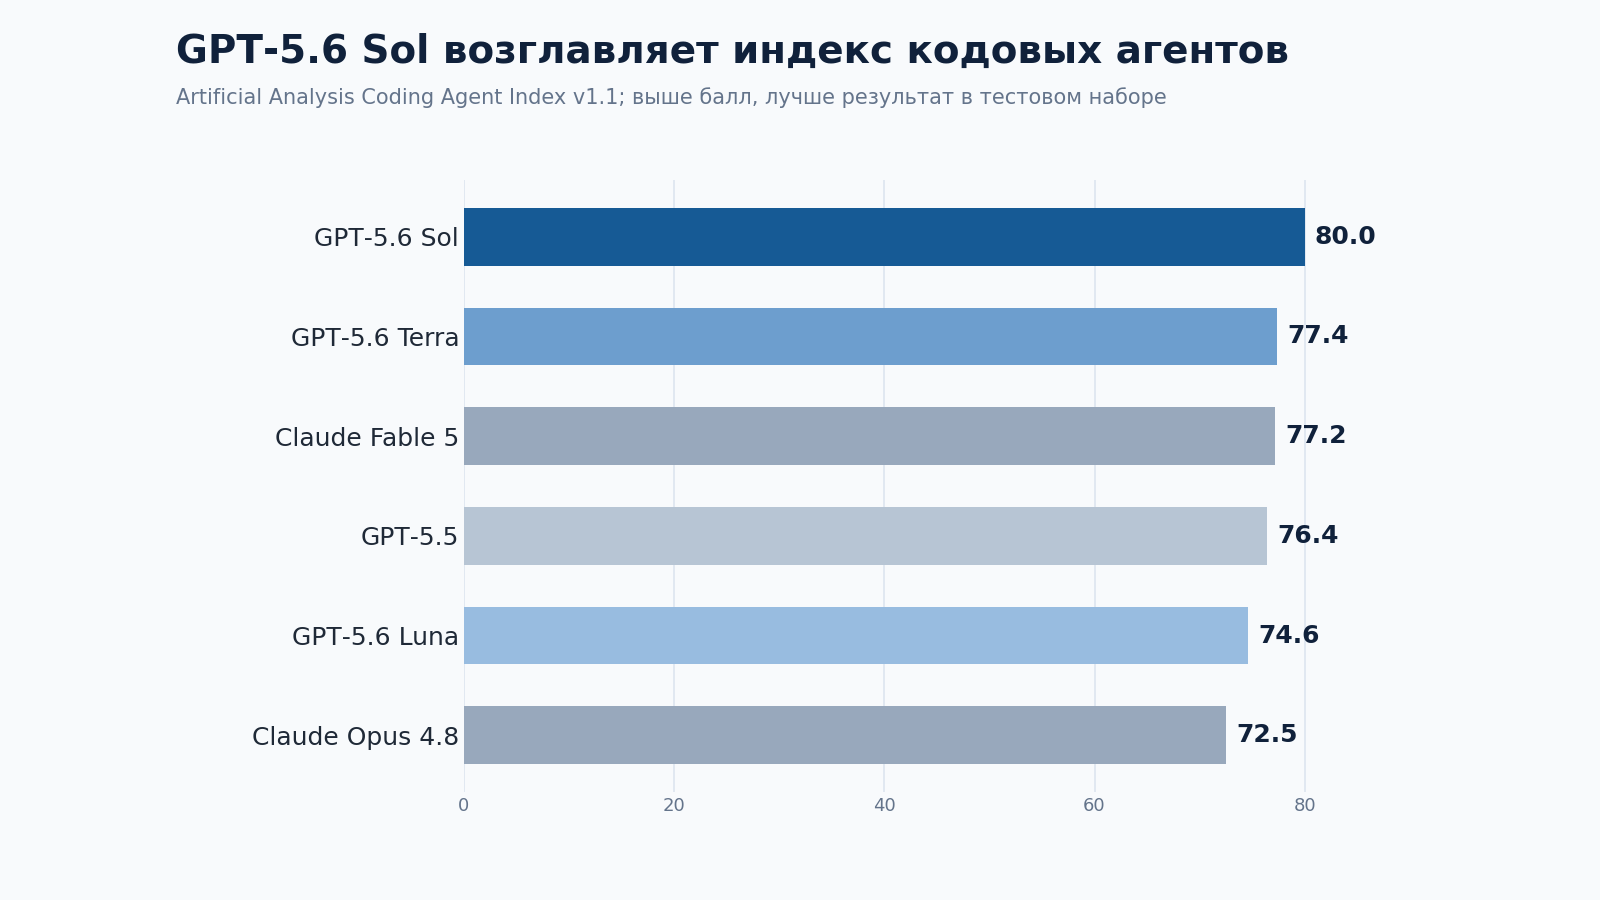
В Coding Agent Index Sol получила 80 баллов и возглавила опубликованное сравнение. Terra набрала 77,4, Luna 74,6, GPT‑5.5 76,4. Такой тест проверяет не красоту отдельного фрагмента кода, а способность агента планировать работу, пользоваться терминалом, сохранять контекст и выполнять действия в репозитории.
Для разработчика это полезно прежде всего в длинных задачах: разбор логов, поиск регрессии, подготовка pull request, рефакторинг, написание тестов, проверка зависимостей. Модель может быстрее пройти путь от симптома к гипотезе и предложить патч, но production доступы и финальное решение все равно должны оставаться у команды.
В API OpenAI делает ставку на Programmatic Tool Calling. Модель может запускать небольшие программы в памяти, фильтровать промежуточные данные и координировать инструменты без лишних возвратов в контекст. Для сложных сценариев доступен многоагентный режим в бета-версии: подзадачи выполняются параллельно, после чего итог синтезируется в одном ответе.
Это не повод отдавать модели право на самостоятельные релизы. Безопасная схема остается прежней: изолированная среда, ограничения по доступам, понятный лог действий и обязательный code review. Сильный агент нужен не для того, чтобы исключить человека из процесса, а чтобы сократить путь к проверяемому изменению.
Сколько стоит GPT‑5.6 через API
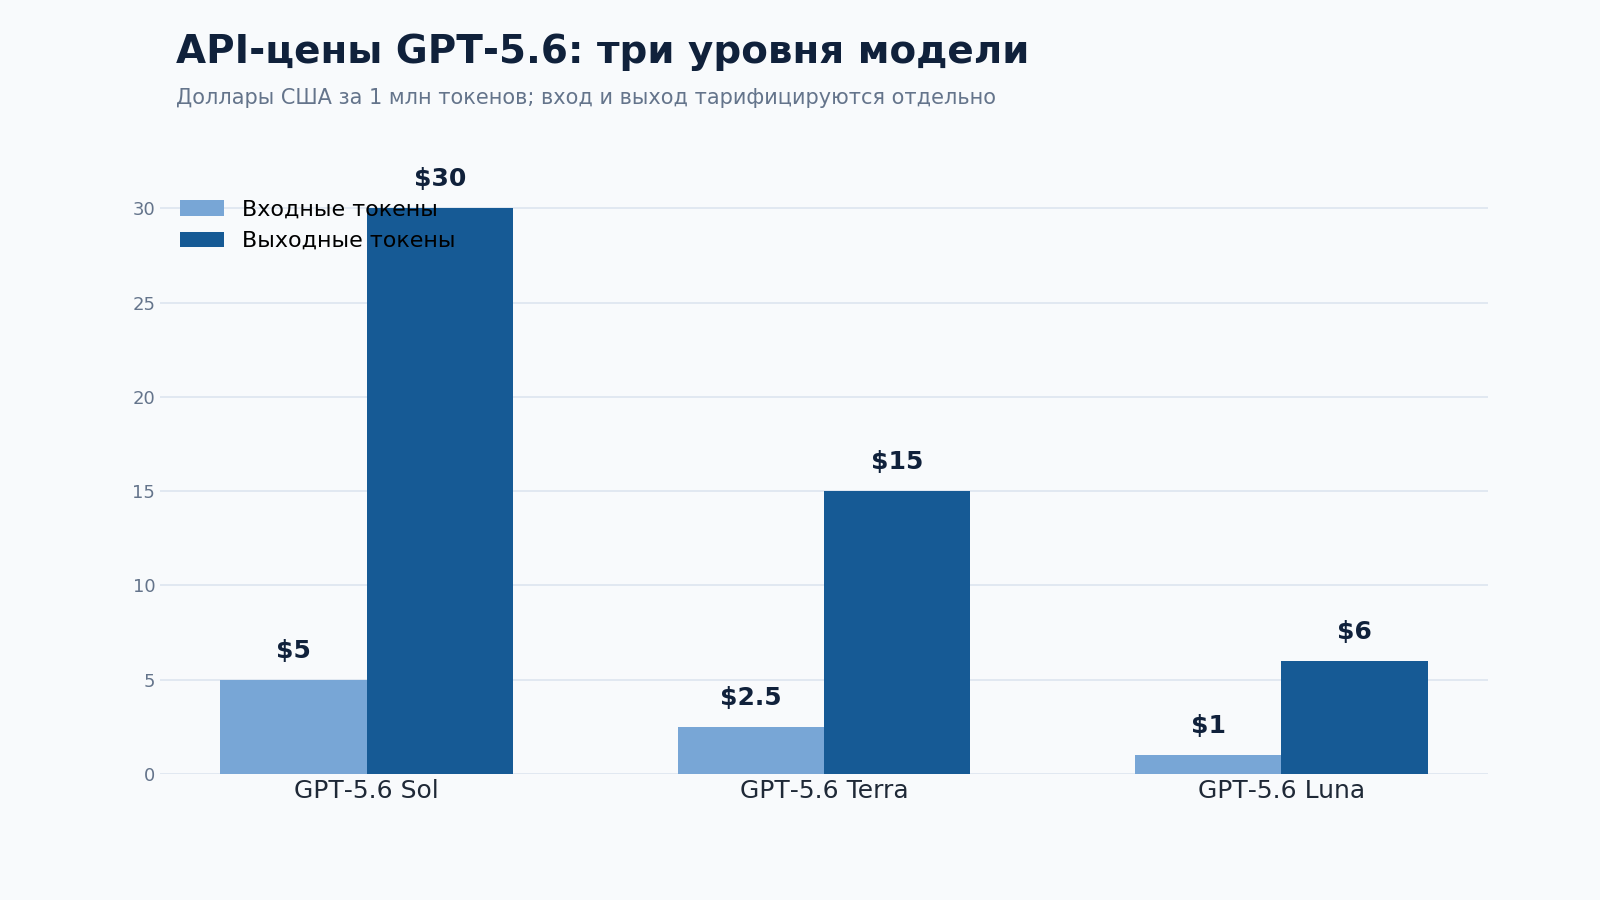
Тарифы разделены по входным и выходным токенам. У Sol цена составляет 5 долларов за миллион входных и 30 долларов за миллион выходных токенов. У Terra это 2,50 и 15 долларов, у Luna 1 и 6 долларов. Разница важна не только для инженеров: в агентных сценариях итоговая смета быстро растет, если модель постоянно генерирует длинные промежуточные ответы.
В GPT‑5.6 появилась отдельная тарификация записи в кэш. По данным OpenAI, она в 1,25 раза выше обычной цены входных токенов, а чтение из кэша сохраняет 90-процентную скидку от базовой стоимости входа. Для команд с повторяющимся большим контекстом это может быть заметно, но выгода возникает только при аккуратной архитектуре запросов.
Перед выбором модели стоит считать не цену одного вызова, а стоимость завершенной работы. В нее входят повторные запросы, ошибки формата, ручная правка, неудачные обращения к инструментам и время специалиста. Иногда Sol дороже на уровне токенов, но дешевле по полной стоимости результата. Иногда Terra или Luna выигрывают, потому что задача не требует флагманского уровня.
Документы, интерфейсы и ChatGPT Work
OpenAI связывает GPT‑5.6 с ChatGPT Work, режимом для работы с файлами, приложениями и длинными проектами. Его смысл не в том, чтобы заменить рабочий процесс одним промптом. Пользователь задает цель, дает модели ограниченный контекст, наблюдает за ходом работы и подтверждает важные действия.
Для маркетинга это может быть путь от результатов исследования к брифу кампании и первым вариантам материалов. Для финансовой команды: сверка источников, объяснение отклонений и подготовка презентации. Для продукта и разработки: превращение набора требований в план, прототип и последовательность проверок. В каждом случае важнее хорошо описанные входные данные, чем эффектное название модели.
GPT‑5.6 также заявлена как более сильная модель для работы с шаблонами. В документах и презентациях это особенно ценно: система должна не просто составить текст, а понять структуру референса, сохранить типографику, отступы, логику слайдов и повторяющиеся паттерны. Полученный файл все равно нуждается в финальной редактуре, но количество технической ручной работы может сократиться.
Что не видно в бенчмарках
Один и тот же результат в таблице может стоить командам по-разному. В тесте модель получает заранее заданную среду, ограниченный набор инструментов и понятную метрику успеха. В реальной работе появляются неполные документы, устаревшие файлы, разный стиль постановки задач, внутренние правила доступа и люди, которые по-разному оценивают качество. Поэтому даже сильный бенчмарк не заменяет проверку на вашем материале.
Особенно это заметно в русскоязычных коммерческих текстах и документах, где важны интонация, юридическая точность, терминология бренда и конкретные ограничения. Модель может хорошо обобщить данные, но пропустить мелкую деталь из договора, неправильно прочитать показатель в таблице или слишком уверенно сформулировать вывод. Чем ближе результат к внешней публикации, деньгам или правам доступа, тем больше должна быть роль редактора и профильного специалиста.
Три рабочих сценария
В маркетинговом процессе GPT‑5.6 может разобрать исследования аудитории, выделить повторы в отзывах, собрать бриф кампании и подготовить несколько форматов материалов. Terra подойдет для регулярной подготовки черновиков и разметки информации. Sol имеет смысл подключать к сложному конкурентному анализу, финальной логике презентации или задачам, где нужно связать десятки источников и не потерять аргументацию.
В разработке Luna может взять на себя дешевые и частые операции: классификацию тикетов, первичное извлечение ошибок из логов, типовые пояснения к изменениям. Terra подойдет для разборов задач в репозитории и подготовки патчей. Sol нужен там, где агенту приходится держать длинную цепочку контекста, проверять несколько гипотез, выстраивать план изменений и проходить через серию тестов.
В операционной работе полезнее всего заранее разделить роли. Младшая модель собирает и сортирует входящие данные, средняя превращает их в рабочий черновик, старшая проверяет сложные исключения и формирует итог для человека. Такой подход проще контролировать, чем попытка решить все одной мощной моделью. Он также делает затраты понятнее для руководителя и команды, которая отвечает за качество результата.
При этом маршрутизация не должна быть догмой. Хорошая команда периодически пересматривает ее по логам ошибок и фактическим затратам. Если Luna стала часто передавать задачи на доработку, ее экономия исчезает. Если Terra стабильно справляется с задачей, которую раньше отправляли в Sol, появляется резерв для снижения стоимости. Такие решения лучше принимать по измерениям, а не по впечатлению от одного демонстрационного кейса.
Удобно вести короткий журнал пилота: задача, выбранная модель, расход, время, итоговая оценка и причина ручной правки. Через несколько недель в нем обычно видны повторяющиеся паттерны. Одни задачи требуют более точного контекста, другие упираются в неясный формат, третьи действительно выигрывают от старшего уровня рассуждений. Эта карта полезнее любого общего рейтинга, потому что описывает именно ваш процесс.
Безопасность и границы автономности
Рост возможностей в программировании, кибербезопасности и науке одновременно расширяет полезные и рискованные сценарии. OpenAI описывает для GPT‑5.6 многоуровневые меры: ограничения внутри модели, проверки в реальном времени, мониторинг и доступ, который зависит от уровня доверия и характера задачи.
Самое практичное правило для команд остается простым: давать модели только тот контекст и те полномочия, которые нужны для конкретного шага. Для внешних действий должны быть точки подтверждения. Для работы с кодом нужна изоляция. Для коммерческих, юридических и медицинских материалов обязательна проверка человека, который отвечает за содержание.
Не стоит путать автономность с отсутствием контроля. Хороший агент может сам собрать черновые данные, подготовить несколько вариантов и показать ход работы. Отправка письма, публикация, изменение прав доступа или выкладка кода должны оставаться отдельными подтверждаемыми действиями. Так команда сохраняет скорость и не превращает ИИ в непрозрачный автопилот.
Как выбрать модель для пилота
Чек-лист перед запуском
- Соберите 20–50 типовых задач из реального процесса: от простых до тех, где ошибка действительно дорого стоит.
- Для каждой задачи заранее зафиксируйте критерии: точность фактов, соблюдение формата, время до результата, стоимость и объем ручной правки.
- Запустите Sol, Terra и Luna в одинаковых условиях: с одинаковым контекстом, набором инструментов и уровнем контроля.
- Отдельно посчитайте долю ответов, которые потеряли факт, нарушили формат, застряли на шаге или потребовали серьезной переработки.
- После пилота закрепите маршрутизацию: какие типы задач идут в Luna, какие в Terra и в каких случаях команда переключается на Sol.
Скачать расширенную памятку можно в приложенном PDF. В ней эта последовательность собрана в один лист, который удобно использовать при запуске теста с несколькими моделями.
Частые вопросы
Когда вышла GPT‑5.6?
OpenAI анонсировала семейство GPT‑5.6 9 июля 2026 года. На старте модели были заявлены для ChatGPT, Codex и API. Доступность зависит от продукта, тарифа и этапа развертывания.
Чем Sol отличается от Terra и Luna?
Sol рассчитана на сложные задачи и максимальное качество. Terra дает баланс качества и стоимости для регулярной работы. Luna подходит для массовых и менее критичных сценариев, где важны скорость и цена единицы работы.
Что такое режим ultra?
OpenAI описывает ultra как старший режим для особенно сложных задач. Он по умолчанию координирует четыре параллельных агента, поэтому может быстрее довести многошаговую работу до результата, но требует больше вычислений.
Есть ли GPT‑5.6 в бесплатном ChatGPT?
По условиям релиза Free и Go получают Terra в ChatGPT Work и Codex. Доступ к Sol, Luna и расширенным режимам зависит от тарифа и может изменяться по мере развертывания.
Нужно ли сразу переходить с GPT‑5.5?
Переход стоит проверять на пилоте, если команда работает с длинными цепочками действий, кодом, документами и сложными файлами. Для простой генерации текста улучшение промпта и исходных данных иногда дает больший эффект, чем смена модели.
Итог
GPT‑5.6 интересна тем, что объединяет несколько направлений в одной линейке: глубокое рассуждение, работу с инструментами, экономию токенов, агентные процессы и создание рабочих материалов. Но модель не отменяет постановку задачи, качество исходных данных и ответственность специалиста, который принимает финальное решение.
Sol, Terra и Luna дают командам возможность не покупать максимальную мощность везде. Самый рациональный подход: проверить модели на собственном наборе задач, посчитать полную стоимость результата и закрепить понятные правила маршрутизации. Бенчмарки помогают начать разговор, а пилот показывает, что будет происходить в реальном процессе.
Источники
Вопросы и ответы
Когда вышла GPT‑5.6?
OpenAI анонсировала семейство GPT‑5.6 9 июля 2026 года. На старте модели заявлены для ChatGPT, Codex и API; доступность зависит от продукта и тарифа.
Чем Sol отличается от Terra и Luna?
Sol рассчитана на сложные и дорогие по ошибке задачи. Terra дает баланс качества и стоимости для повседневной работы. Luna нужна для частых и менее критичных операций, где важна экономика.
Что такое режим ultra?
Это старший режим для сложных задач. OpenAI описывает его как конфигурацию, в которой по умолчанию координируются четыре параллельных агента.
Есть ли GPT‑5.6 в бесплатном ChatGPT?
По условиям релиза Free и Go получают Terra в ChatGPT Work и Codex. Набор моделей и режимов зависит от тарифа и может меняться по мере развертывания.
Стоит ли сразу переходить с GPT‑5.5?
Переход стоит проверить на пилоте, если в работе есть длинные цепочки действий, код, сложные документы или агентные задачи. Для простой генерации текста эффект может быть заметно меньше.


