

Что именно появилось и почему это не новый DeepSeek
В публичном каталоге AMD на Hugging Face доступны квантизованные сборки DeepSeek-R1. Среди них указаны amd/DeepSeek-R1-MXFP4, amd/DeepSeek-R1-0528-MXFP4 и вариант amd/DeepSeek-R1-0528-MXFP4-MTP-MoEFP4. Это не новая ветка модели от DeepSeek и не совместный запуск AMD и DeepSeek. Карточки связывают артефакты с базовыми открытыми весами DeepSeek-R1 и DeepSeek-R1-0528.
Корректная формулировка здесь важнее громкого анонса: AMD распространяет аппаратно-ориентированные квантизованные артефакты DeepSeek-R1. В них меняются формат представления весов, инструменты подготовки и маршрут запуска, но не появляется самостоятельная новая базовая модель DeepSeek.
С датой 28 июля стоит обращаться осторожно. Она стала свежим сигналом в мониторинге Hugging Face и Google News, однако первичные страницы не дают безусловного подтверждения, что все упомянутые веса впервые появились именно в этот день. В файловых деревьях и коллекциях видны обновления, а не полная история публикации каждого артефакта.
Для рынка важен не спор о моменте появления страницы, а сам тип релиза. В первые месяцы вокруг R1 обсуждали reasoning-способности, длинные цепочки рассуждений, бенчмарки и стоимость API. Теперь заметнее становится другой слой: на каких GPU модель запускается, через какие runtime ее обслуживают, в каком формате хранятся веса и насколько предсказуемо система ведет себя под нагрузкой.
Это признак инфраструктурного взросления экосистемы DeepSeek. Открытые веса остаются исходным активом, но для реального внедрения нужны еще квантизация, драйверы, контейнеры, движки инференса, настройки памяти и понятная документация. Именно на этом слое AMD предлагает свои MXFP4-сборки.
Цитата в переводе«Базовая модель: deepseek-ai/DeepSeek-R1-0528.»
Что такое MXFP4 и почему для DeepSeek-R1 это не косметика
MXFP4 относится к низкоразрядным форматам представления чисел, ориентированным на 4-битное хранение и вычисления с масштабированием. В упрощенном виде квантизация уменьшает точность представления весов и или активаций, чтобы снизить требования к памяти и пропускной способности. Для больших языковых моделей это критично: при генерации каждый токен проходит через большой массив параметров и промежуточных вычислений.
DeepSeek-R1 относится к reasoning-моделям, рассчитанным на многошаговое рассуждение, и использует подход MoE, mixture of experts, или «смесь экспертов». При такой архитектуре во время обработки токена задействуется не весь набор параметров, а часть специализированных блоков. Это помогает масштабировать модель, но не отменяет инфраструктурную нагрузку: веса необходимо хранить, перемещать между устройствами, синхронизировать вычисления и обслуживать запросы с приемлемой задержкой.
В карточке amd/DeepSeek-R1-0528-MXFP4 указано применение OCP MXFP4 к весам в статическом режиме и к активациям в динамическом режиме. Статическая квантизация означает, что веса заранее преобразованы в целевой формат. Динамическая квантизация активаций работает со значениями, возникающими уже во время выполнения модели.
Такое сочетание может уменьшить нагрузку на память и передачу данных, но требует аккуратной настройки. Квантизация не делает модель умнее и не гарантирует сохранения качества. Она меняет инженерный профиль модели: если качество сохраняется в приемлемых пределах, выигрыш может быть в стоимости и доступности инференса. Если нет, модель становится дешевле или быстрее ценой потери способности решать часть сложных задач.
Поэтому в подобных релизах имеют значение не только файлы safetensors. Нужны процедуры оценки, параметры запуска, версии библиотек и указание целевого оборудования. Без этих деталей цифра «4 бита» мало говорит о том, как модель поведет себя в конкретном сервисе.
Как AMD упаковывает DeepSeek-R1 под свой стек
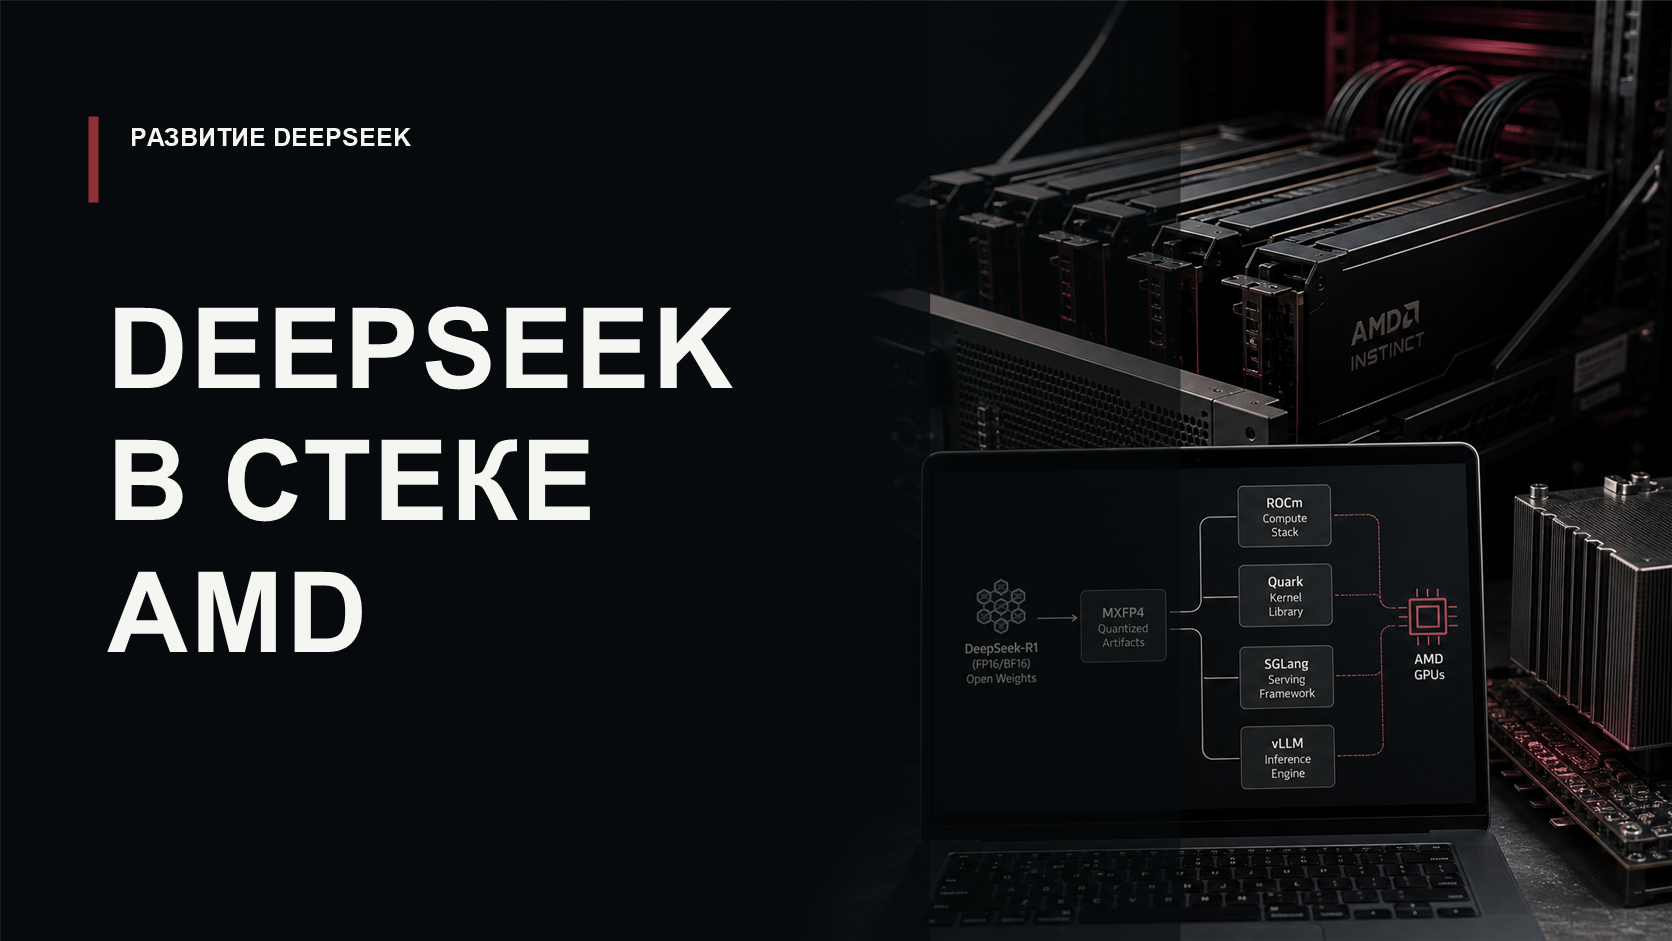
Карточка amd/DeepSeek-R1-0528-MXFP4 показывает конкретный маршрут деплоя. В ней указаны AMD Instinct MI350 и MI355, ROCm 7.0, PyTorch 2.8.0, Transformers 4.53.0, SGLang и vLLM. Это не абстрактная публикация весов для всех возможных случаев, а сборка для определенного класса ускорителей и программной инфраструктуры.
ROCm является программной платформой AMD для вычислений на GPU. По роли в экосистеме AMD ее обычно сопоставляют с CUDA в экосистеме NVIDIA. SGLang и vLLM служат движками обслуживания больших языковых моделей: они участвуют в эффективной генерации, батчинге запросов, работе с KV-cache и распределении нагрузки.
В связке с Quark, инструментом AMD для квантизации, эти компоненты превращают исходный модельный чекпойнт в более законченный пакет для инференса. Для инженерной команды это важнее, чем само наличие страницы на Hugging Face. Практическая ценность появляется, когда между весами и работающим сервером есть воспроизводимый маршрут.
В индустрии LLM все чаще конкурируют не одиночные веса, а связки из модели, формата квантизации, runtime, kernels, контейнеров и документации. В дата-центре такая связка влияет на цену миллиона токенов не меньше, чем различие в несколько пунктов на академическом benchmark.
В материале AMD о ROCm 7.0 отдельно продвигаются готовые Docker-образы для vLLM и SGLang на Instinct-платформах, а также MXFP4 и FP8-модели, подготовленные с помощью AMD Quark. Это заявление вендора, а не независимая проверка производительности. Однако оно показывает стратегию AMD: разработчику предлагают видеть не отдельный ускоритель, а цепочку от Hugging Face-артефакта до сервера инференса.
Цитата в переводе«Готовые к production модели MXFP4/FP8.»
Что говорят цифры в карточках моделей
У amd/DeepSeek-R1-0528-MXFP4 на Hugging Face указано 356B parameters, лицензия MIT и файловое дерево порядка сотен гигабайт. В проверочном досье фигурирует около 403 GB для файлового дерева. Эти значения нельзя трактовать как обещание запуска на потребительском ноутбуке: речь идет о масштабе дата-центровой или как минимум специализированной multi-GPU-инфраструктуры.
AMD приводит собственные результаты оценки для R1-0528-MXFP4. По карточке, на AIME24 базовая модель показывает 88,00, а квантизованный вариант 85,00. На GPQA Diamond указано 79,90 против 79,34, на MATH-500 97,06 против 97,84. Результаты говорят о сравнительно умеренной разнице на части тестов и небольшом превышении на MATH-500.
Но делать из этих чисел универсальный вывод о качестве нельзя. Это self-reported evaluation от стороны, которая публикует артефакт. Для внедрения важны собственные тесты на целевых задачах, длинном контексте, коде, агентных цепочках и пользовательских запросах, а не только результаты на ограниченном наборе бенчмарков.
Для amd/DeepSeek-R1-MXFP4 указано 371B parameters и 129 205 downloads last month на момент проверки в досье. В оценках этой сборки AIME24 снижается с 78,0 до 69,57, а GSM8K с 95,81 до 93,95. Этот пример показывает, что 4-битная упаковка влияет на разные задачи и версии модели неодинаково.
Отдельный amd/DeepSeek-R1-0528-MXFP4-MTP-MoEFP4 в карточке указывает 350B parameters и Quark v0.11. По приведенной там оценке GSM8K у base-модели указано 94,24, у quantized variant 94,90. Это интересный сигнал, но одного GSM8K недостаточно для вывода о сохранении общего качества reasoning-модели.
Почему это не локальный DeepSeek для любого ПК
Квантизация часто провоцирует упрощенный вывод: если модель сжали до 4 бит, она автоматически стала потребительской. Для полного DeepSeek-R1-0528-MXFP4 это неверно. В карточке в качестве аппаратной цели названы AMD Instinct MI350 и MI355, то есть серверные ускорители, а не массовые видеокарты или NPU в ноутбуках.
Страница Hugging Face дополнительно указывает, что этот артефакт не развернут ни у одного Inference Provider. Пользователь не получает универсальную кнопку запуска в облаке Hugging Face. Для работы модели необходимо скачать веса, развернуть подходящую среду, настроить движок инференса и обеспечить достаточную память и межсоединения между ускорителями.
Низкоразрядный формат снижает требования относительно исходного представления модели, но не отменяет ее общий масштаб. Полный R1-0528-MXFP4 остается тяжелым дата-центровым артефактом. Его появление не является практической инструкцией для установки полного DeepSeek-R1 на домашний компьютер.
Для локальных сценариев обычно нужно смотреть на другой класс моделей: меньшие варианты, в том числе дистиллированные сборки DeepSeek-R1, если они соответствуют конкретной задаче и доступному оборудованию. Дистиллят способен воспроизводить часть поведения более крупной модели, но не равен полному R1-0528 по составу параметров и ожидаемому потолку качества.
Смешивать эти два направления не стоит. Крупные MXFP4-сборки под Instinct и ROCm адресованы дата-центровому инференсу. Небольшие модели для локальных и гибридных сценариев имеют иной бюджет памяти, другой профиль качества и другую экономику запуска.
Цитата в переводе«Эта модель не развернута ни у одного Inference Provider.»
Что меняется для рынка инференса
Рынок больших моделей постепенно выходит из фазы, в которой главным событием была новая карточка с результатами на AIME, MATH или GPQA. Эти метрики по-прежнему важны, но для команд, обслуживающих пользователей, критичны и другие вопросы: сколько стоит токен, как ведет себя latency под нагрузкой, как заполняется память GPU, можно ли масштабировать модель на несколько устройств и насколько стабильна программная цепочка.
DeepSeek-R1 стал заметным примером открытой reasoning-модели. Но открытые веса являются только половиной истории. Чтобы модель появилась в продукте, ее нужно подготовить к инфраструктуре: выбрать формат весов, настроить runtime, проверить драйверы, развернуть обслуживающий движок, организовать мониторинг и обновления. MXFP4-варианты AMD относятся именно к этому практическому слою.
Для AMD он имеет стратегическое значение. NVIDIA сильна не только благодаря GPU, но и благодаря зрелости CUDA-экосистемы, библиотекам, tooling и привычкам разработчиков. ROCm должен показывать не только абстрактную совместимость, но и возможность обслуживать популярные и тяжелые модели через понятный стек.
DeepSeek-R1 удобен для такой демонстрации: модель известна, требовательна к памяти и интересна разработчикам, ищущим альтернативы закрытым API. Однако публикация MXFP4-чекпойнта не доказывает массовый перенос production-инференса DeepSeek на MI350 или MI355. Это инфраструктурное предложение, которое еще предстоит проверить на надежность, стоимость владения и качество в собственных нагрузках.
Hugging Face в такой схеме работает не просто как каталог моделей. Площадка становится витриной того, насколько разные аппаратные экосистемы готовы к запуску популярных open-weight LLM. Производитель ускорителей может показать там веса, формат, версии библиотек, команды оценки и рекомендуемый путь развертывания.
Российский контекст: интерес не в хайпе, а в переносимости
Для российской аудитории этот сюжет не стоит читать как обещание немедленно запустить полный DeepSeek-R1 дома. Полезнее другой вывод: крупные открытые модели все чаще распространяются в виде аппаратно-специфичных сборок. Это влияет на разговор о внедрении ИИ в организациях, где использование внешнего API ограничивают политики безопасности, требования к данным или нестабильность поставщиков.
Если компания хочет держать инференс ближе к своим данным, ей приходится выбирать не одну модель, а весь стек. В него входят ускорители, драйверы, контейнеры, движок обслуживания, формат весов, мониторинг и процедура обновления. Публикация AMD на Hugging Face показывает, как такой стек начинает оформляться вокруг DeepSeek-R1.
Практический порог входа при этом остается высоким. Полный R1-0528-MXFP4 требует серверного класса оборудования. Даже при успешной квантизации команде нужно оценить доступную память, сеть между ускорителями, версии ROCm и библиотек, устойчивость сервиса под параллельной нагрузкой и результаты на собственных данных.
Для рабочих станций и ноутбуков реалистичнее рассматривать меньшие модели, не выдавая их за полный R1-0528. Они могут быть полезны для ассистентов, прототипирования, локального поиска по документам и экспериментов без обращения к внешнему API. Компромисс понятен: ниже требования к железу, но другой потолок качества.
Разработчикам полезно смотреть не на формулу «DeepSeek стал легче», а на инженерный паттерн. Сначала появляются открытые веса, затем производители железа публикуют квантизованные сборки, после этого вокруг них формируются контейнеры, inference-движки, инструкции и бенчмарки. Этот путь определяет, какие модели действительно доходят до частных контуров и локальных инсталляций.
Где проходит граница между фактом, позицией AMD и прогнозом
Факт: на Hugging Face существуют AMD-репозитории с квантизованными вариантами DeepSeek-R1 и DeepSeek-R1-0528. В карточках указаны базовые модели, форматы MXFP4 и FP4, Quark, SGLang, vLLM и аппаратная ориентация на Instinct MI350 и MI355 для R1-0528-MXFP4. Артефакты доступны как файлы и инструкции, а не как универсальный hosted-сервис Hugging Face.
Позиция AMD: компания продвигает ROCm 7.0, Quark, контейнеры и оптимизации инференса как путь к production-ready обслуживанию больших моделей, включая DeepSeek R1. Это описание стратегии вендора. Оно не заменяет независимые замеры цены токена, пропускной способности, энергопотребления или устойчивости под реальной нагрузкой.
Прогноз: аппаратно-настроенных сборок будет становиться больше. Чем тяжелее модели и чем дороже длинный контекст, тем сильнее стимул у производителей ускорителей публиковать собственные кванты и оптимизированные маршруты запуска. Это логичное направление рынка, но не факт о конкретном будущем релизе.
Редакционная интерпретация состоит в том, что DeepSeek-R1 развивается не только через новые версии, но и через инфраструктурное обрастание. Такой процесс менее заметен широкой аудитории, чем новая таблица benchmark, но важнее для внедрения. Модель без экономичного и воспроизводимого маршрута запуска остается демонстрацией; модель с понятной аппаратной сборкой, runtime и документацией получает шанс стать рабочим компонентом.
Что это означает на практике
Публикация AMD полезна как ориентир для команд, которые оценивают запуск DeepSeek-R1 на AMD Instinct или сравнивают варианты инфраструктуры. Она не отменяет необходимость собственного тестирования и не превращает полный R1-0528 в массовую локальную модель.
- Для разработчиков с доступом к AMD Instinct MI350 или MI355 это более прямой путь от весов на Hugging Face к запуску через ROCm, SGLang или vLLM.
- Для команд, оценивающих альтернативы NVIDIA-стеку, артефакты дают проверяемую точку входа: можно изучить формат, заявленные версии библиотек, команды запуска и self-reported evaluation AMD.
- Для локального использования на ПК полный DeepSeek-R1-0528-MXFP4 не является реалистичным массовым вариантом. Нужны меньшие модели, соответствующие доступному оборудованию и задачам.
- MXFP4 может снизить требования к памяти и пропускной способности, но не гарантирует сохранения качества на всех задачах. Цифры AMD следует проверять на собственных наборах данных.
- Редакционно точная формулировка: это не новая модель DeepSeek и не доказанное массовое внедрение, а аппаратно-ориентированная упаковка существующих open-weight моделей.
Вывод
История с MXFP4-вариантами DeepSeek-R1 на Hugging Face показывает, куда смещается конкуренция вокруг открытых LLM. Уже недостаточно опубликовать сильную модель и таблицы бенчмарков. Следующий этап состоит в том, чтобы сделать ее запускаемой, предсказуемой и экономически осмысленной на конкретной инфраструктуре.
AMD использует DeepSeek-R1 как показательный объект для своего inference-стека: Quark отвечает за квантизацию, ROCm за GPU-программирование, SGLang и vLLM за обслуживание, а Instinct MI350 и MI355 выступают аппаратной целью. Это не доказывает автоматическое преимущество AMD и не отменяет позиции NVIDIA, но добавляет практический маршрут для open-weight reasoning-моделей.
Для DeepSeek такой маршрут важен сам по себе. Модель продолжает жить не только в API и сравнительных таблицах, но и в производственных сборках, оптимизированных под железо. Так крупные открытые модели переходят из статуса громкого релиза в статус инфраструктурного компонента.
Источники
- AMD: amd/DeepSeek-R1-0528-MXFP4 на Hugging Face
- AMD: amd/DeepSeek-R1-MXFP4 на Hugging Face
- AMD: файловое дерево amd/DeepSeek-R1-MXFP4 на Hugging Face
- AMD: файловое дерево amd/DeepSeek-R1-0528-MXFP4 на Hugging Face
- AMD: коллекция Quark Quantized MXFP4 Models на Hugging Face
- AMD: ROCm 7 Built for Developers, Ready for Enterprises
Частые вопросы
MXFP4-сборка AMD означает выход новой модели DeepSeek?
Нет. Карточки AMD связывают сборки с базовыми открытыми весами DeepSeek-R1 и DeepSeek-R1-0528. Изменяется инженерная упаковка для инференса, а не появляется самостоятельная новая ветка модели.
Можно ли запустить полный DeepSeek-R1-0528-MXFP4 на обычном ПК?
Материал не дает оснований считать такой запуск массовым потребительским сценарием. В карточке указана ориентация на серверные AMD Instinct MI350 и MI355, а размер файлового дерева измеряется сотнями гигабайт.
Что дает квантизация MXFP4?
Она может снизить требования к памяти и пропускной способности за счет низкоразрядного представления весов и активаций. При этом качество необходимо проверять на конкретных задачах: эффект квантизации неодинаков для разных тестов и моделей.
Почему важны ROCm, SGLang и vLLM?
Они образуют часть маршрута развертывания. ROCm предоставляет программную платформу AMD для GPU, а SGLang и vLLM используются для обслуживания больших языковых моделей, включая генерацию, батчинг запросов и работу с KV-cache.
Можно ли считать результаты AMD на бенчмарках независимым доказательством качества?
Нет. Это self-reported evaluation стороны, публикующей артефакт. Такие результаты полезны для первичной оценки, но для внедрения нужны собственные тесты на рабочих данных и целевой инфраструктуре.
Практический чек-лист
Проверка MXFP4-сборки DeepSeek-R1 перед пилотом
Этот чек-лист помогает не принять публикацию квантизованного чекпойнта за готовое решение для production или локального ПК.
Проверить границы релиза
- Убедиться, что сборка основана на нужной базовой модели DeepSeek-R1 или DeepSeek-R1-0528.
- Не называть квантизованный артефакт новой моделью DeepSeek.
- Отделить факт существования репозитория от предположений о массовом внедрении.
Проверить инфраструктуру
- Сопоставить целевые ускорители, версию ROCm, версии библиотек и выбранный движок инференса.
- Оценить объем памяти, размер файлов, межсоединения между ускорителями и требования к развертыванию.
- Проверить, подходит ли сценарий для серверной инфраструктуры, а не переносить ожидания на обычный ПК.
Проверить качество и экономику
- Не ограничиваться self-reported evaluation от поставщика артефакта.
- Запустить тесты на собственных данных, включая целевые типы запросов и нужную длину контекста.
- Сравнить задержку, стабильность, потребление памяти и стоимость обслуживания с альтернативными вариантами.
Вопросы и ответы
MXFP4-сборка AMD означает выход новой модели DeepSeek?
Нет. Карточки AMD связывают сборки с базовыми открытыми весами DeepSeek-R1 и DeepSeek-R1-0528. Изменяется инженерная упаковка для инференса, а не появляется самостоятельная новая ветка модели.
Можно ли запустить полный DeepSeek-R1-0528-MXFP4 на обычном ПК?
Материал не дает оснований считать такой запуск массовым потребительским сценарием. В карточке указана ориентация на серверные AMD Instinct MI350 и MI355, а размер файлового дерева измеряется сотнями гигабайт.
Что дает квантизация MXFP4?
Она может снизить требования к памяти и пропускной способности за счет низкоразрядного представления весов и активаций. При этом качество необходимо проверять на конкретных задачах: эффект квантизации неодинаков для разных тестов и моделей.
Почему важны ROCm, SGLang и vLLM?
Они образуют часть маршрута развертывания. ROCm предоставляет программную платформу AMD для GPU, а SGLang и vLLM используются для обслуживания больших языковых моделей, включая генерацию, батчинг запросов и работу с KV-cache.
Можно ли считать результаты AMD на бенчмарках независимым доказательством качества?
Нет. Это self-reported evaluation стороны, публикующей артефакт. Такие результаты полезны для первичной оценки, но для внедрения нужны собственные тесты на рабочих данных и целевой инфраструктуре.


