



Как мы составляли рейтинг
Text-to-Speech уже нельзя оценивать только по принципу «голос похож на человеческий или нет». В 2026 году сервисы заметно различаются по назначению: одни заточены под выразительный voice-over, другие под корпоративные API, третьи под разговорных агентов с минимальной задержкой. Поэтому в рейтинге GPT House нет одного универсального победителя для всех сценариев.
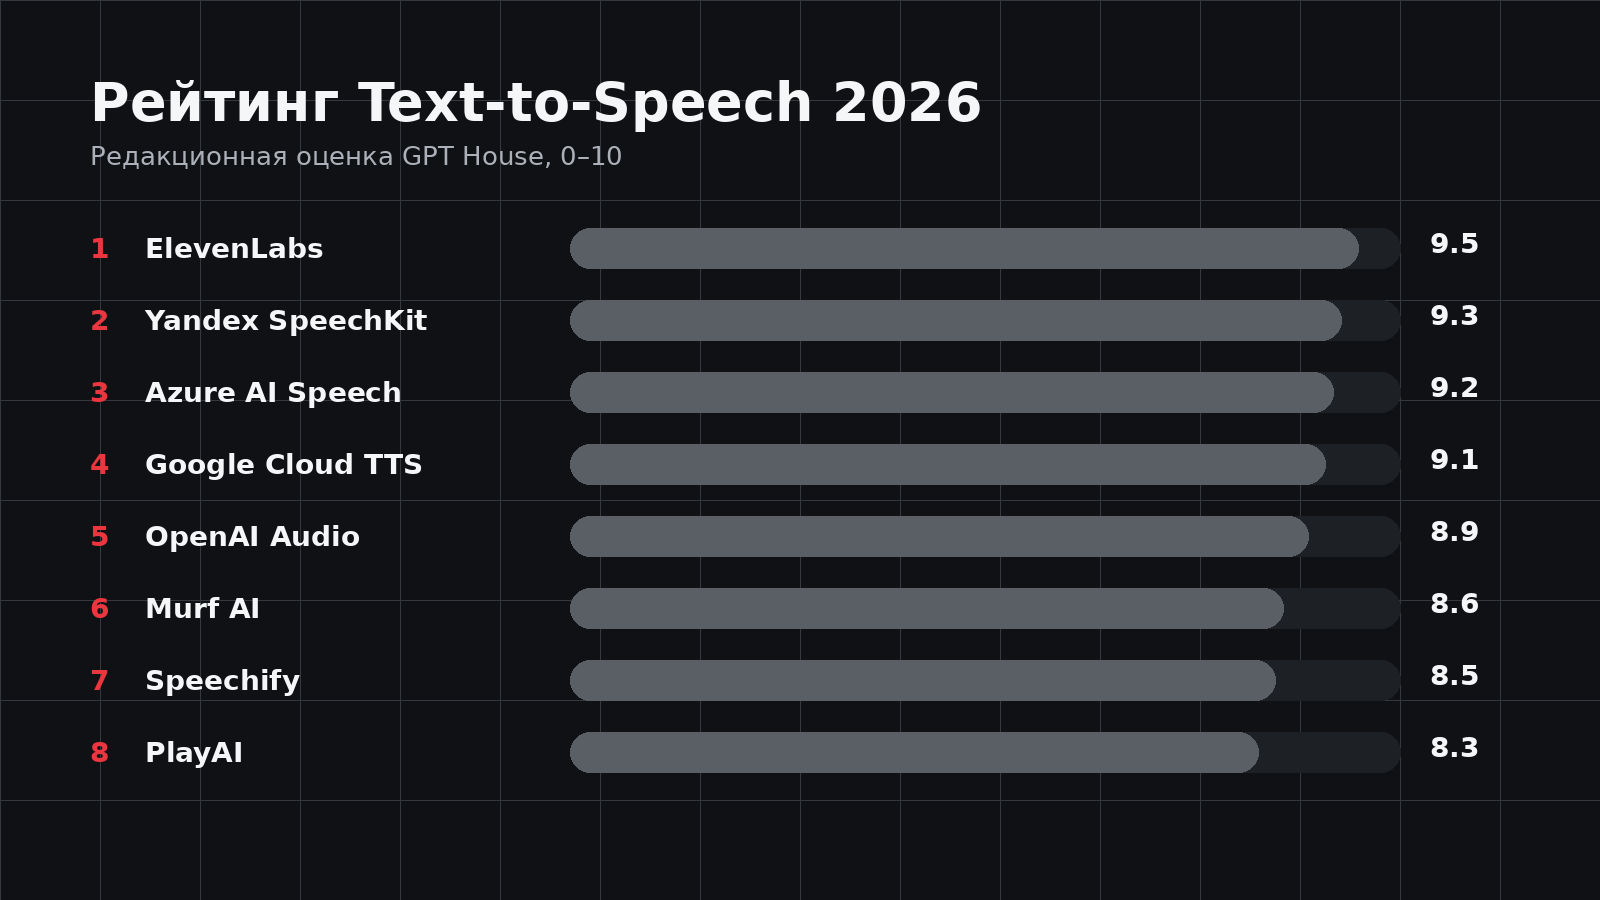
Мы сравнивали восемь решений из рабочего лидерборда блока: ElevenLabs, Yandex SpeechKit, Microsoft Azure AI Speech, Google Cloud Text-to-Speech, OpenAI Audio, Murf AI, Speechify и PlayAI. Итоговая оценка редакционная. Это не внешний Elo-бенчмарк: единого независимого теста, который одинаково измеряет все эти продукты, сейчас нет.
Основные критерии: естественность речи, интонация и просодия, качество русского языка, выбор голосов, управляемость произношения, удобство API и интеграций, скорость генерации, стоимость и ограничения коммерческого использования. Для русскоязычного проекта отдельно важно проверять ударения, числа, фамилии, аббревиатуры и смешанные русско-английские фразы.
Рейтинг нейросетей для озвучки текста в 2026 году
В первой пятёрке оказались сервисы с разной специализацией. ElevenLabs лидирует как универсальная voice-платформа для выразительной озвучки. Yandex SpeechKit особенно силён в русскоязычных продуктовых сценариях. Azure AI Speech и Google Cloud Text-to-Speech выигрывают там, где важны зрелый облачный стек, API и масштабирование. OpenAI Audio логичнее рассматривать не как обычную студию дикторской озвучки, а как голосовой слой для LLM-приложений и realtime-диалогов.
Murf AI, Speechify и PlayAI остаются полезными кандидатами, но перед публикацией конкретного проекта им нужен отдельный ручной тест русского языка, текущих тарифов и доступности функций. Для TTS это принципиально: наличие русского языка в списке ещё не гарантирует естественное чтение сложного текста.
1. ElevenLabs: лучший универсальный вариант для выразительной озвучки
ElevenLabs занимает первое место за сочетание естественности, выразительности и зрелого набора инструментов. В актуальной линейке есть Eleven v3 для эмоциональной речи, v3 Conversational для диалогов, Multilingual v2 для длинного мультиязычного аудио и Flash/Turbo для сценариев, где важна задержка.
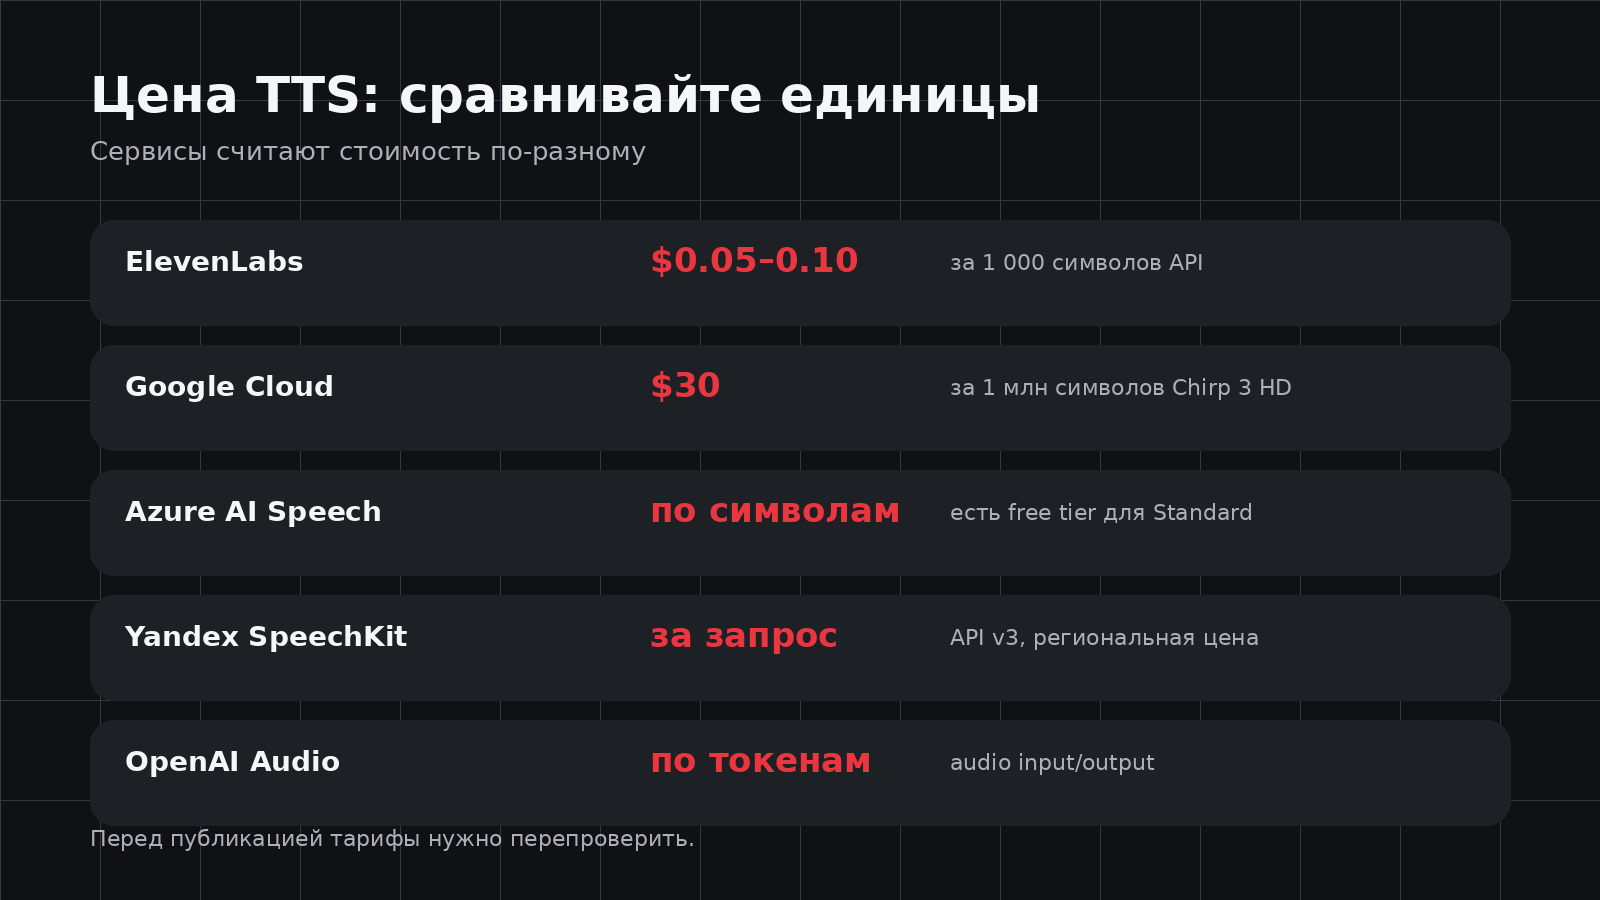
На API-странице ElevenLabs для v3 указана цена $0,10 за 1 000 символов, а для v3 Conversational и Flash/Turbo: $0,05 за 1 000 символов. Компания также заявляет поддержку более 70 языков в v3 и задержку около 75 мс у Flash. Для создателей контента важны voice library, клонирование голоса и возможность управлять подачей через контекст и audio tags.
Для русского языка ElevenLabs стоит тестировать на конкретном голосе. В документации компания прямо предупреждает: если голос изначально не обучался на нужном языке, в синтезе может появиться акцент. Поэтому для русского проекта лучше выбирать голос, обученный на русском или близком акценте, а не ориентироваться только на красивое англоязычное демо.
Кому подойдёт: ролики, подкасты, аудиогиды, обучающий контент, voice-over, игровые персонажи и продукты, где качество подачи важнее минимальной цены.
2. Yandex SpeechKit: сильный выбор для русского языка и продуктовых интеграций
SpeechKit занимает второе место и становится первым кандидатом, если основной язык продукта русский. В актуальной документации Yandex Cloud перечисляет голоса с основным языком, полом, доступными амплуа и поддерживаемой версией API. Это удобно для системного подбора голоса, а не только для разовой озвучки.
API v3 тарифицируется по запросам. В документации для региона Казахстан указано ограничение по умолчанию в 250 символов и 24 секунды на запрос; для более длинных фраз предусмотрены unsafe_mode и потоковый режим. Стоимость зависит от региона, поэтому цифру нельзя переносить из одной юрисдикции в другую без проверки.
Сильная сторона SpeechKit: прикладные сценарии: голосовые помощники, телефония, call-центры, уведомления, интерфейсы и автоматизированная озвучка. Для брендов доступна линейка Brand Voice, но условия хостинга и использования нужно проверять отдельно.
Кому подойдёт: русскоязычные сервисы, контакт-центры, голосовые интерфейсы, автоматизация и проекты, которым нужен стабильный API.
3. Microsoft Azure AI Speech: для enterprise и тонкого управления
Azure AI Speech: зрелая облачная платформа, где TTS является частью большого речевого стека Microsoft. Сервис поддерживает стандартные и мультиязычные голоса, SSML, REST/SDK-интеграции и сценарии custom voice. В официальной документации отдельно описаны professional voice и personal voice.
Для русского языка в каталоге присутствует локаль ru-RU. Управление через SSML полезно там, где нужно задавать паузы, произношение, формат дат, чисел и другие параметры. Это делает Azure удобным для корпоративных сценариев, в которых воспроизводимость важнее «магии одной кнопки».
Тарификация Text-to-Speech основана на количестве обработанных символов. На странице цен Microsoft также указан бесплатный объём для Standard TTS. Конкретные цены и доступность отдельных HD/custom-функций зависят от региона и уровня сервиса, поэтому перед внедрением их нужно сверять в Azure.
Кому подойдёт: enterprise-приложения, контакт-центры, внутренние системы, продукты на Microsoft-стеке и команды, которым нужен SSML-контроль.
4. Google Cloud Text-to-Speech: для мультиязычных продуктов и масштаба
Google Cloud Text-to-Speech выделяется масштабом каталога и зрелой инфраструктурой. На продуктовой странице Google заявляет более 380 голосов в 75+ языках и вариантах. В списке поддерживаемых голосов есть ru-RU, включая Standard, WaveNet и Chirp 3 HD.
Сервис поддерживает SSML, настройку высоты, скорости и громкости, а также REST и gRPC API. Это особенно удобно для приложений, где синтез встроен в backend и должен работать стабильно при большом количестве запросов.
Цена зависит от семейства голосов. На актуальной странице Google Cloud Chirp 3 HD стоит $30 за 1 млн символов после бесплатного лимита, а legacy-линейки имеют другие ставки. В 2026 году на той же странице уже присутствует Gemini-TTS с токеновой тарификацией, поэтому при расчёте бюджета важно сначала выбрать конкретный класс модели.
Кому подойдёт: международные приложения, облачные продукты, автоматическая озвучка больших объёмов и команды, уже использующие Google Cloud.
5. OpenAI Audio: когда голос является частью AI-диалога
OpenAI Audio стоит рассматривать отдельно от классических TTS-студий. Его сильная сторона: голос внутри LLM-сценария: пользователь говорит с приложением, модель понимает контекст и отвечает аудио. Для realtime-ассистента это часто важнее, чем каталог из сотен дикторских голосов.
Такой подход подходит для голосовых помощников, интерактивных консультантов и приложений, где текстовый ответ не является конечным артефактом. При этом OpenAI Audio не стоит автоматически ставить выше специализированных voice-over платформ для аудиокниг, рекламы или дубляжа: задачи разные.
Кому подойдёт: разработчики conversational AI, realtime-помощников и продуктов, где голос тесно связан с reasoning и диалогом.
6. Murf AI: удобная студия для маркетинга и презентаций
Murf AI ориентирован на пользователей, которым нужен не только API, но и готовый студийный workflow: загрузить текст, подобрать голос, собрать озвучку и использовать её в презентации или ролике. Это снижает порог входа для маркетинга и контент-команд.
В рейтинге сервис находится ниже облачных лидеров, потому что для русскоязычного материала требуется повторная ручная проверка актуального каталога голосов, тарифов и условий коммерческого использования. Если проект англоязычный, Murf может выглядеть сильнее, чем показывает общий рейтинг.
Кому подойдёт: презентации, маркетинговые ролики, обучение и команды без отдельного разработчика.
7. Speechify: удобен для озвучки документов и пользовательского контента
Speechify вырос из продукта для чтения текстов вслух и остаётся сильным в consumer-сценариях. Его логика понятна пользователю: документ или текст быстро превращается в аудио без сложной настройки инфраструктуры.
Для редакционного рейтинга GPT House мы не считаем удобство интерфейса достаточным основанием для более высокой позиции. Перед выбором Speechify для русского проекта нужно отдельно проверить доступные голоса, ограничения конкретного плана, API и коммерческие права.
Кому подойдёт: чтение документов, персональная озвучка и creator-сценарии, где важен простой интерфейс.
8. PlayAI: платформа для voice-приложений, которую стоит тестировать на своём сценарии
PlayAI закрывает voice-first сценарии и предлагает API-интеграции, поэтому остаётся в shortlist. Однако его позиция наиболее зависима от ручной проверки: перед публикацией и тем более внедрением нужно подтвердить текущую продуктовую линейку, поддержку русского языка, тарифы и условия клонирования голоса.
Кому подойдёт: эксперименты с voice apps и командами, которые готовы проводить собственное сравнительное тестирование.
Как выбрать нейросеть для озвучки
Выбор лучше начинать не с бренда, а с конечного аудио. Один и тот же сервис может отлично читать короткие рекламные реплики и хуже справляться с длинной инструкцией, фамилиями или телефонными номерами.
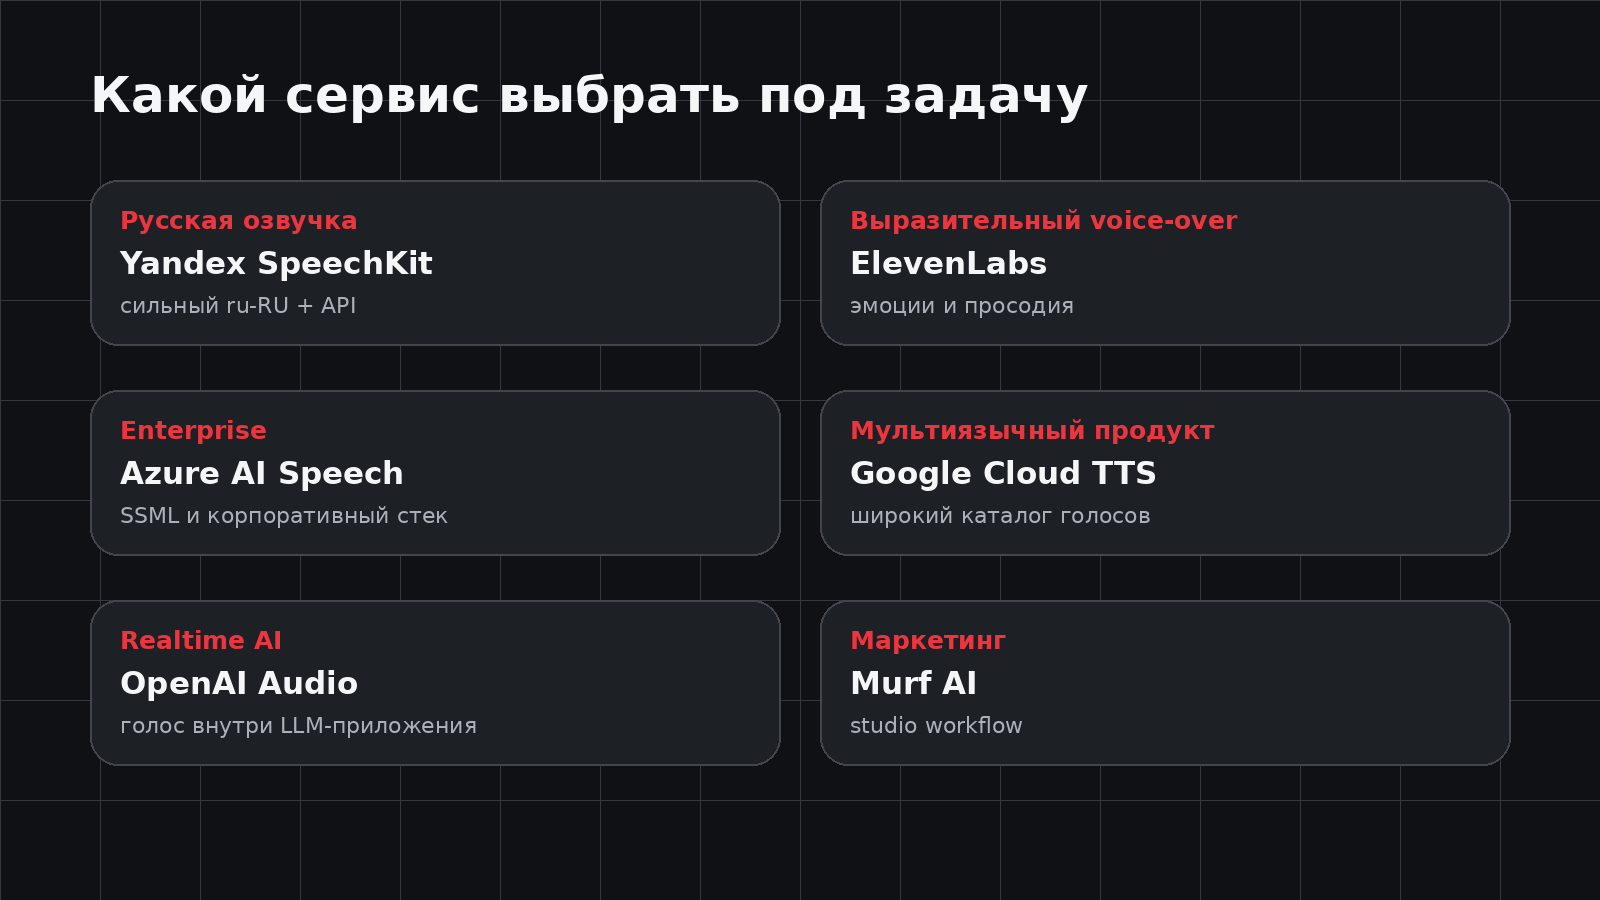
Для контента и voice-over сначала сравните ElevenLabs, Murf и Speechify. Для русскоязычного продукта добавьте SpeechKit. Для enterprise-интеграции логично тестировать Azure и Google Cloud. Для разговорного AI отдельно проверьте OpenAI Audio и low-latency модели ElevenLabs.
Как проверить качество русского голоса
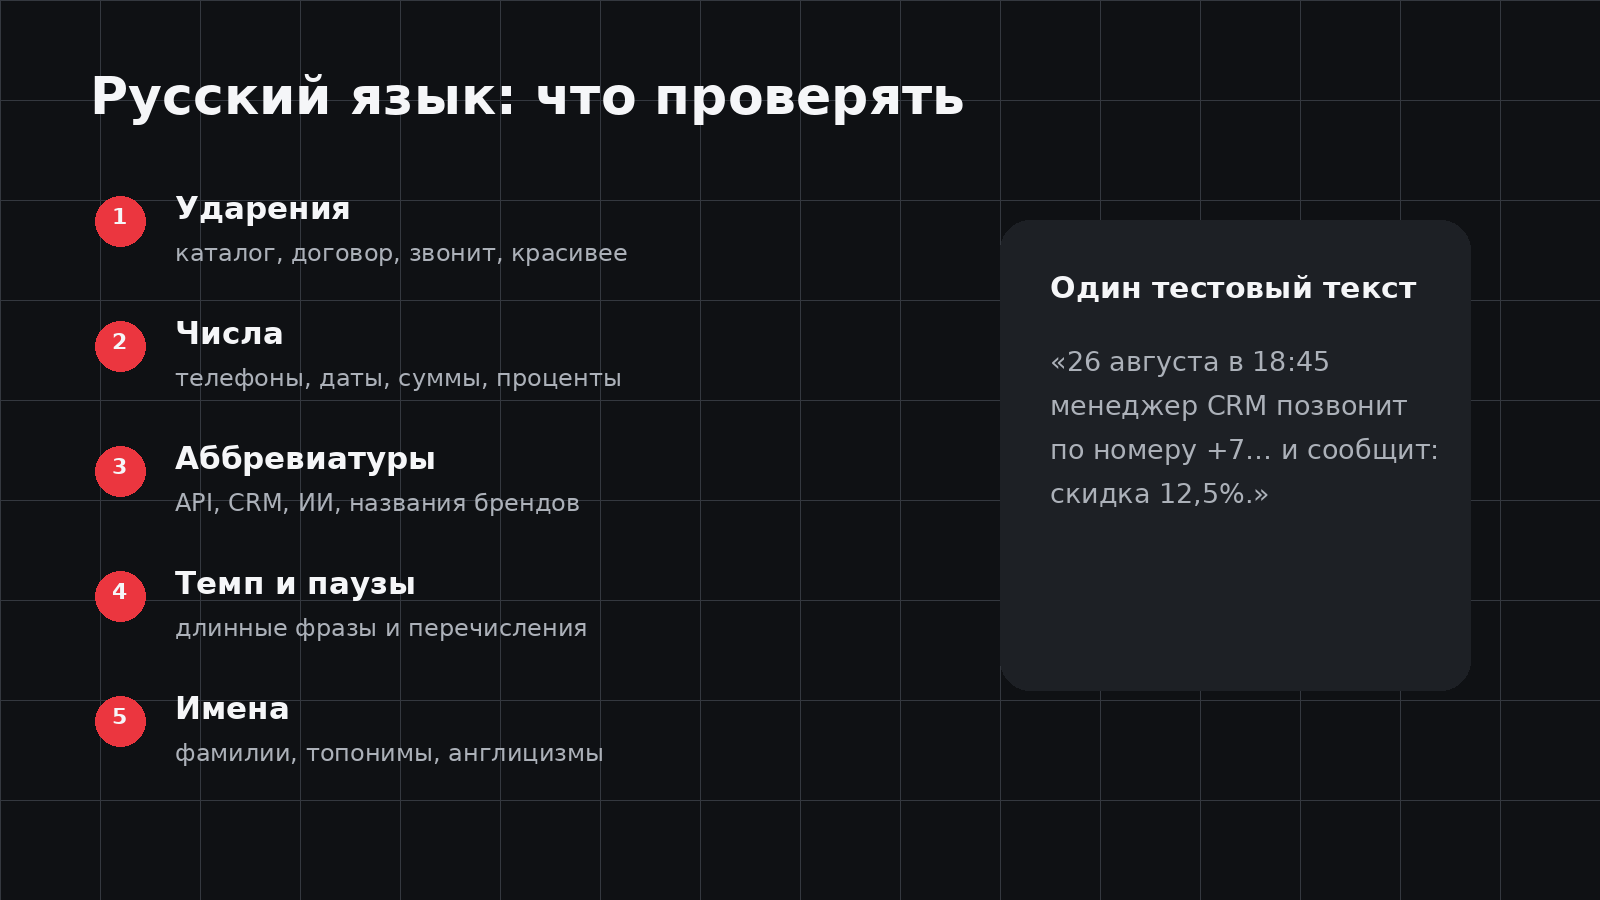
Сделайте единый тестовый текст и прогоните его через все сервисы без ручного «подкручивания» одного участника. В тексте должны быть даты, время, проценты, сумма, номер телефона, аббревиатура, англицизм, фамилия и слово со спорным ударением. После первого прогона можно провести второй тест уже с настройками SSML или pronunciation dictionaries, если сервис их поддерживает.
Слушать нужно не только тембр. Отмечайте неправильные ударения, слишком длинные паузы, скачки темпа, неестественные окончания предложений, чтение цифр и то, как голос ведёт себя на абзацах длиной 500–1000 знаков.
Бесплатные режимы и стоимость: почему нельзя сравнивать только цену за минуту
У TTS нет единой единицы тарификации. ElevenLabs API считает символы, Google Cloud использует символы для классического TTS и токены для Gemini-TTS, Azure считает обрабатываемые символы, SpeechKit API v3 тарифицирует запросы, а LLM-native audio может использовать токеновую модель. Поэтому фраза «этот сервис дешевле за минуту» без описания модели и режима часто вводит в заблуждение.
Бесплатный тариф полезен для теста голоса, но не всегда отражает стоимость production-нагрузки. При расчёте бюджета учитывайте не только генерацию, но и повторные прогоны, длинные тексты, concurrency, хранение аудио, custom voice и требования к региону обработки данных.
Voice cloning: удобная функция с юридическими ограничениями
Клонирование голоса нельзя оценивать только как техническую возможность. Для коммерческого проекта важно иметь право использовать исходный голос и понимать правила конкретной платформы. Если сервис предлагает instant cloning, это не означает, что можно загружать запись любого человека без согласия.
Для бренда или публичного продукта лучше документировать согласие диктора, назначение синтетического голоса, допустимые сценарии и порядок отзыва доступа. Для enterprise-проектов дополнительно проверьте хранение исходных записей, retention и регион обработки данных.
Короткий выбор по сценариям
- Нужна максимально выразительная универсальная озвучка: ElevenLabs.
- Основной язык продукта русский: начните тест с Yandex SpeechKit и ElevenLabs.
- Нужен enterprise-стек и SSML: Azure AI Speech.
- Нужна масштабируемая мультиязычная облачная интеграция: Google Cloud Text-to-Speech.
- Строите realtime AI-ассистента: OpenAI Audio или low-latency TTS ElevenLabs.
- Нужна студия без разработки для маркетинга: Murf AI.
- Нужно быстро озвучивать документы: Speechify.
Итог
В 2026 году рынок Text-to-Speech уже разделился на несколько классов продуктов. ElevenLabs сильнее как универсальная платформа для выразительной речи, SpeechKit: как кандидат для русскоязычных продуктовых сценариев, Azure и Google Cloud: как инфраструктурные решения, а OpenAI Audio: как голосовой слой для conversational AI. Поэтому правильный выбор начинается с тестового текста и конкретного сценария, а не с одного общего места в рейтинге.
Перед внедрением обязательно повторите тест на собственных текстах и заново проверьте цены, доступные голоса и ограничения тарифа. Эти параметры меняются быстрее, чем базовые возможности TTS-платформ.
Источники
- ElevenLabs API Pricing
- ElevenLabs Text to Speech
- ElevenLabs: Eleven v3 is Generally Available
- Yandex SpeechKit: список голосов
- Yandex SpeechKit: правила тарификации
- Microsoft Learn: Text to speech overview
- Microsoft Learn: Language and Voice Support for Azure Speech
- Microsoft Azure: Speech pricing
- Google Cloud Text-to-Speech
- Google Cloud: Supported voices and languages
- Google Cloud: Text-to-Speech pricing
- OpenAI API: GPT Audio
- Murf AI
- Speechify
- PlayAI
Вопросы и ответы
Какая нейросеть лучше всего озвучивает текст?
Для универсальной выразительной озвучки в рейтинге GPT House лидирует ElevenLabs. Для русского продуктового сценария стоит отдельно сравнить ElevenLabs и Yandex SpeechKit.
Какая нейросеть лучше говорит по-русски?
Одного ответа для всех текстов нет. SpeechKit ориентирован на русскоязычные сценарии, а ElevenLabs даёт сильную выразительность. Финальный выбор лучше делать по единому тестовому тексту.
Можно ли бесплатно озвучить текст нейросетью?
Да, у части сервисов есть бесплатные лимиты или пробные режимы. Они подходят для тестирования, но условия и лимиты нужно проверять перед использованием.
Что лучше для API: Azure, Google Cloud или SpeechKit?
SpeechKit особенно интересен для русского языка, Azure — для enterprise и SSML-контроля, Google Cloud — для масштабируемых мультиязычных приложений.
Подходит ли OpenAI для обычной озвучки текста?
Да, но OpenAI Audio особенно силён в conversational и realtime-сценариях. Для длинного voice-over специализированные TTS-платформы могут быть удобнее.
Можно ли клонировать голос другого человека?
Техническая возможность не означает право на использование. Для клонирования и коммерческого применения нужно иметь согласие и соблюдать правила конкретной платформы.