

Короткий ответ
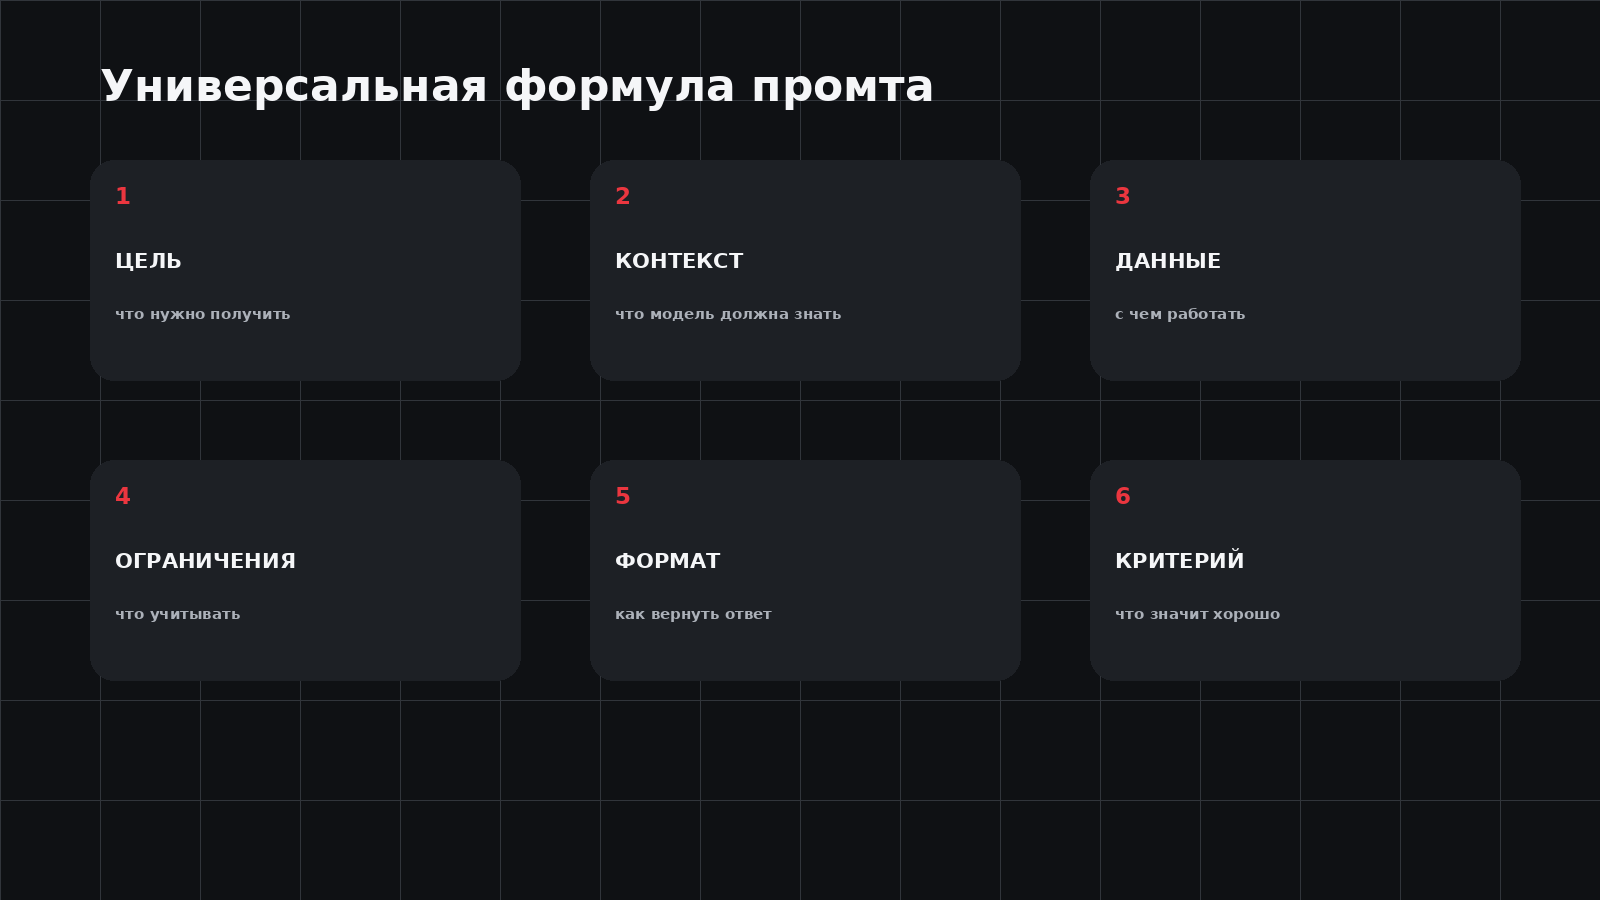
Хороший промт в 2026 году не обязан быть длинным. Универсальная рабочая формула состоит из шести элементов: цель, контекст, данные, ограничения, формат результата и критерий качества.
Для простой задачи достаточно первых двух или трёх элементов. Чем выше цена ошибки и чем стабильнее должен быть результат, тем полезнее явно задать формат, examples и способ проверки.
Главное изменение последних лет: prompt engineering всё меньше похож на поиск «секретной фразы». OpenAI, Anthropic и Google в актуальной документации сходятся в базовом принципе: инструкции должны быть ясными и конкретными, а prompt нужно проверять и уточнять на реальном output.
Почему старые формулы промтов уже недостаточны
В интернете по-прежнему популярны конструкции из десятков пунктов: назначить роль, описать характер эксперта, потребовать «думать пошагово», добавить эмоциональные усилители и несколько раз запретить ошибаться.
Часть таких приёмов когда-то помогала слабее управляемым моделям. Но современные модели лучше следуют прямым инструкциям, а провайдеры всё чаще публикуют model-specific guidance.
OpenAI рекомендует использовать последние модели, формулировать инструкции конкретно и задавать желаемый формат. Для ChatGPT отдельно подчёркиваются clarity, context и iterative refinement.
Anthropic ставит model-specific guidance первым разделом документации и прямо предупреждает, что техники, измеренные на одной модели, стоит перепроверять на другой. Google также называет prompt design итеративным процессом и рекомендует экспериментировать на конкретном use case.
Формула: цель + контекст + данные + ограничения + формат + критерий
Эта формула не является обязательным синтаксисом. Это редакционная модель GPT House, которая помогает не забыть ключевые части задания.
Цель отвечает на вопрос «что нужно сделать». Контекст объясняет ситуацию и аудиторию. Данные содержат материал, который нужно анализировать или преобразовать. Ограничения задают границы. Формат описывает форму ответа. Критерий определяет, по чему вы поймёте, что результат хороший.
Для запроса «придумай 10 названий» можно ограничиться целью и контекстом. Для анализа коммерческого предложения лучше добавить исходный документ, критерии сравнения, запрет на выдуманные данные и формат таблицы.
Чем повторяемее задача, тем важнее критерий. Он превращает prompt из разового запроса в шаблон, который можно тестировать.
1. Цель: сначала скажите, какой результат нужен
Слабый prompt часто начинается с темы вместо задачи: «маркетинг ресторана», «анализ конкурентов», «резюме». Модель вынуждена сама угадывать, что именно пользователь хочет получить.
Лучше использовать глагол действия и объект: сравни, сократи, найди, объясни, классифицируй, составь, проверь, преобразуй.
Пример: вместо «стратегия продвижения кофейни» напишите «составь план продвижения новой кофейни на первые 8 недель». Уже одна эта правка уменьшает пространство для случайной интерпретации.
2. Контекст: дайте модели информацию, которая меняет решение
Контекст нужен не ради объёма. Добавляйте только то, что влияет на результат: аудиторию, рынок, уровень знаний, роль документа, этап проекта, ограничения команды.
Anthropic предлагает простой тест: покажите prompt коллеге с минимальным контекстом. Если человек не поймёт задачу, модель тоже может интерпретировать её неправильно.
Полезный контекст отвечает на вопрос «почему задача выглядит именно так». Например, текст для CEO, инструкция новичку и пост для клиента требуют разной глубины и языка.
3. Данные: отделяйте материал от инструкции
Если модель должна работать с документом, таблицей, заметками или перепиской, явно отделите данные от задания.
Для короткого запроса достаточно подписи «Исходные данные:». В API и сложных prompts можно использовать delimiters или структурированные блоки.
OpenAI в API guidance рекомендует отделять инструкции от контекста. Anthropic для сложных prompts активно использует XML tags, чтобы модель различала instructions, context, inputs и examples.
Ключевое правило: если AI должен опираться только на предоставленные данные, скажите это прямо.
4. Ограничения: задайте реальные границы
Ограничения помогают, когда без них модель может выбрать нежелательный путь. Это может быть длина, бюджет, срок, допустимые источники, аудитория, запрещённые действия или формат данных.
Не превращайте ограничения в страницу из двадцати запретов. Anthropic рекомендует чаще говорить модели, что делать, а не только чего не делать.
Например, вместо «не пиши длинно, не повторяйся, не используй сложные слова» лучше: «ответ до 1 000 знаков, короткими абзацами, язык для неспециалиста».
5. Формат: опишите, как должен выглядеть ответ
Формат особенно важен в рабочих сценариях. Один и тот же анализ можно вернуть как эссе, таблицу, JSON, brief или список решений.
OpenAI рекомендует конкретно описывать desired outcome, length, format и style. Anthropic также отмечает, что examples являются одним из наиболее надёжных способов управлять форматом и структурой.
Если ответ дальше будет использовать человек, задайте удобную структуру. Если результат идёт в автоматизацию, используйте structured output или schema там, где это поддерживается.
6. Критерий качества: объясните, что значит «хорошо»
Фраза «сделай качественно» почти ничего не добавляет. Критерий должен быть проверяемым.
Для исследования это могут быть источники и разделение фактов от гипотез. Для текста сохранение цифр и отсутствие новых фактов. Для стратегии связь каждой рекомендации с исходной проблемой.
Критерии полезны и для self-check: перед финалом можно попросить модель проверить ответ по конкретным требованиям. Но не стоит автоматически добавлять длинные verification-инструкции ко всем моделям: model-specific guidance меняется.
Нужно ли писать «Ты эксперт с 20-летним опытом»
Роль может быть полезна, если она действительно задаёт перспективу, терминологию или аудиторию. Например, «выступи как редактор B2B-медиа и оцени текст по ясности и доказательности».
Но выдуманный стаж сам по себе не гарантирует качество. Anthropic действительно рекомендует role prompting в системном prompt для фокусировки поведения и тона, однако роль должна быть связана с use case.
Для обычного пользователя практичнее сначала уточнить задачу и критерии, а уже затем добавлять роль, если без неё output получается слишком общим.
Нужно ли просить модель «думать пошагово»
Не делайте эту фразу обязательной частью каждого prompt. Современные reasoning-capable models могут сами распределять вычисления и глубину рассуждения.
В актуальной документации Anthropic прямо рекомендует для thinking-capable models предпочитать общие инструкции чрезмерно предписанным шагам. Model-specific поведение при этом различается.
Для пользователя полезнее попросить показать проверяемый результат: допущения, расчёты, источники, промежуточные выводы или критерии выбора, если они действительно нужны.
Examples: когда пример лучше ещё десяти инструкций
Если вам нужен стабильный tone, classification или output structure, хороший пример часто работает лучше абстрактного описания.
Anthropic называет examples одним из наиболее надёжных способов направлять формат, tone и structure и рекомендует делать их релевантными и разнообразными.
Пример должен демонстрировать именно то свойство, которое важно повторить. Не добавляйте случайный sample только потому, что «few-shot prompting считается хорошим».
Как работать с длинными документами
В длинном context важна архитектура prompt. Отделяйте документы, метаданные и инструкции, чтобы модель не путала источник с командой.
Anthropic для long-context tasks рекомендует помещать большие документы выше запроса и инструкций, а сам вопрос ближе к концу. Для сложных наборов документов полезна явная структура.
Не просите модель «изучить всё» без задачи. Укажите, какие факты извлечь, какие сравнения сделать и в каком виде вернуть доказательства.
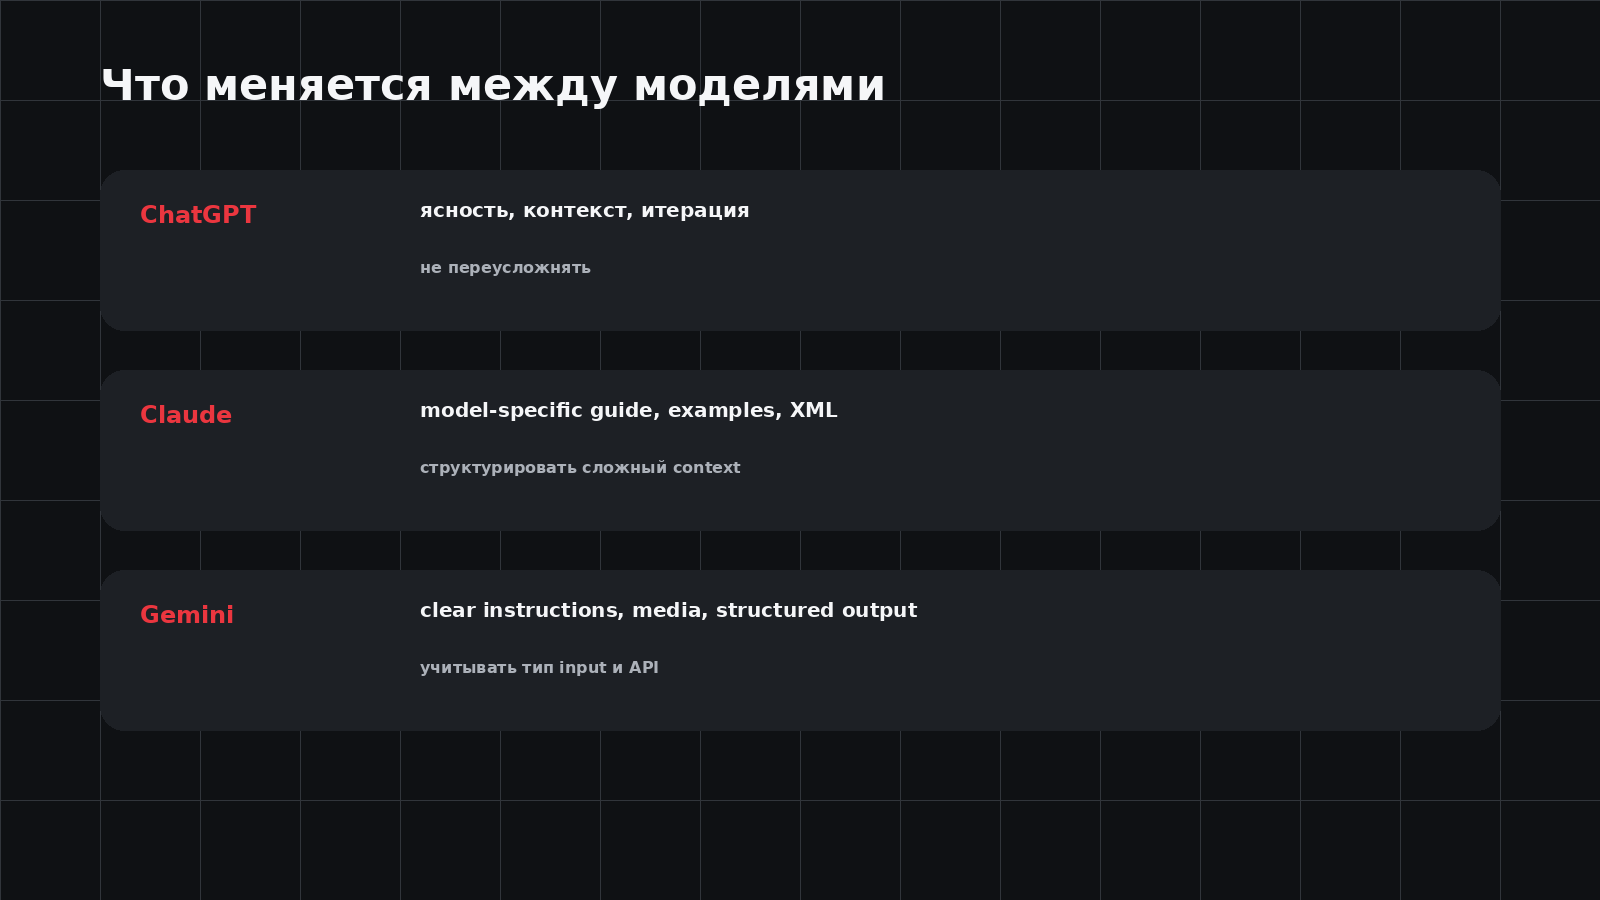
Как отличаются ChatGPT, Claude и Gemini
Базовая формула переносима между системами, но production prompts не стоит считать полностью model-agnostic.
Для ChatGPT OpenAI рекомендует ясность, specificity, context и iterative refinement. В API guidance также важны явный output format и отделение инструкции от данных.
Anthropic сильнее формализует model-specific prompting: отдельные guides идут перед общими техниками. Для сложного Claude prompt полезны XML structure, examples, long-context patterns и явные tool instructions.
Google описывает prompt design для Gemini как итеративный процесс, рекомендует clear and specific instructions и отдельно публикует guides для media, image и video prompting. Это особенно важно в multimodal задачах.
Пример: превращаем слабый prompt в рабочий
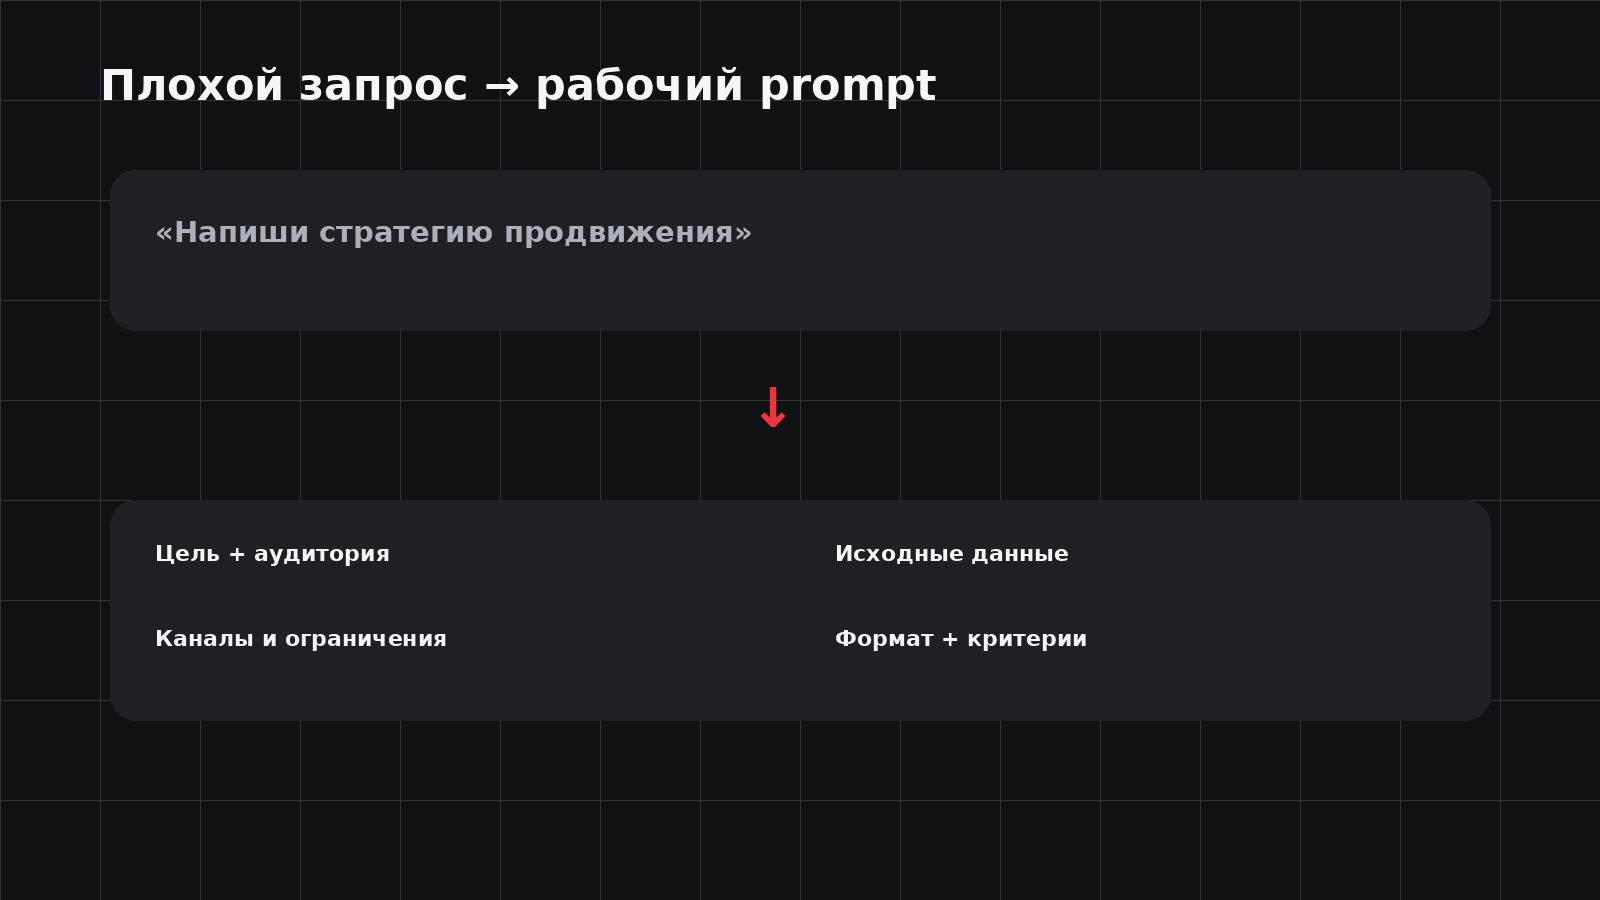
Слабый вариант: «Напиши стратегию продвижения для сервиса доставки еды».
Рабочий вариант:
- Цель: составь план привлечения первых 1 000 платящих клиентов за 3 месяца.
- Контекст: сервис работает в одном городе, средний чек 1 800 ₽, аудитория 25–40 лет, команда из двух маркетологов.
- Данные: текущие каналы, конверсии и бюджет приведены ниже: [данные].
- Ограничения: бюджет до 600 000 ₽ в месяц; не предлагай TV, наружную рекламу и федеральные кампании.
- Формат: таблица по каналам, затем план на 12 недель.
- Критерий: каждая рекомендация должна быть связана с метрикой, способом проверки и условием остановки.
Такой prompt не гарантирует правильную стратегию. Но он значительно лучше задаёт пространство задачи и позволяет проверить output.
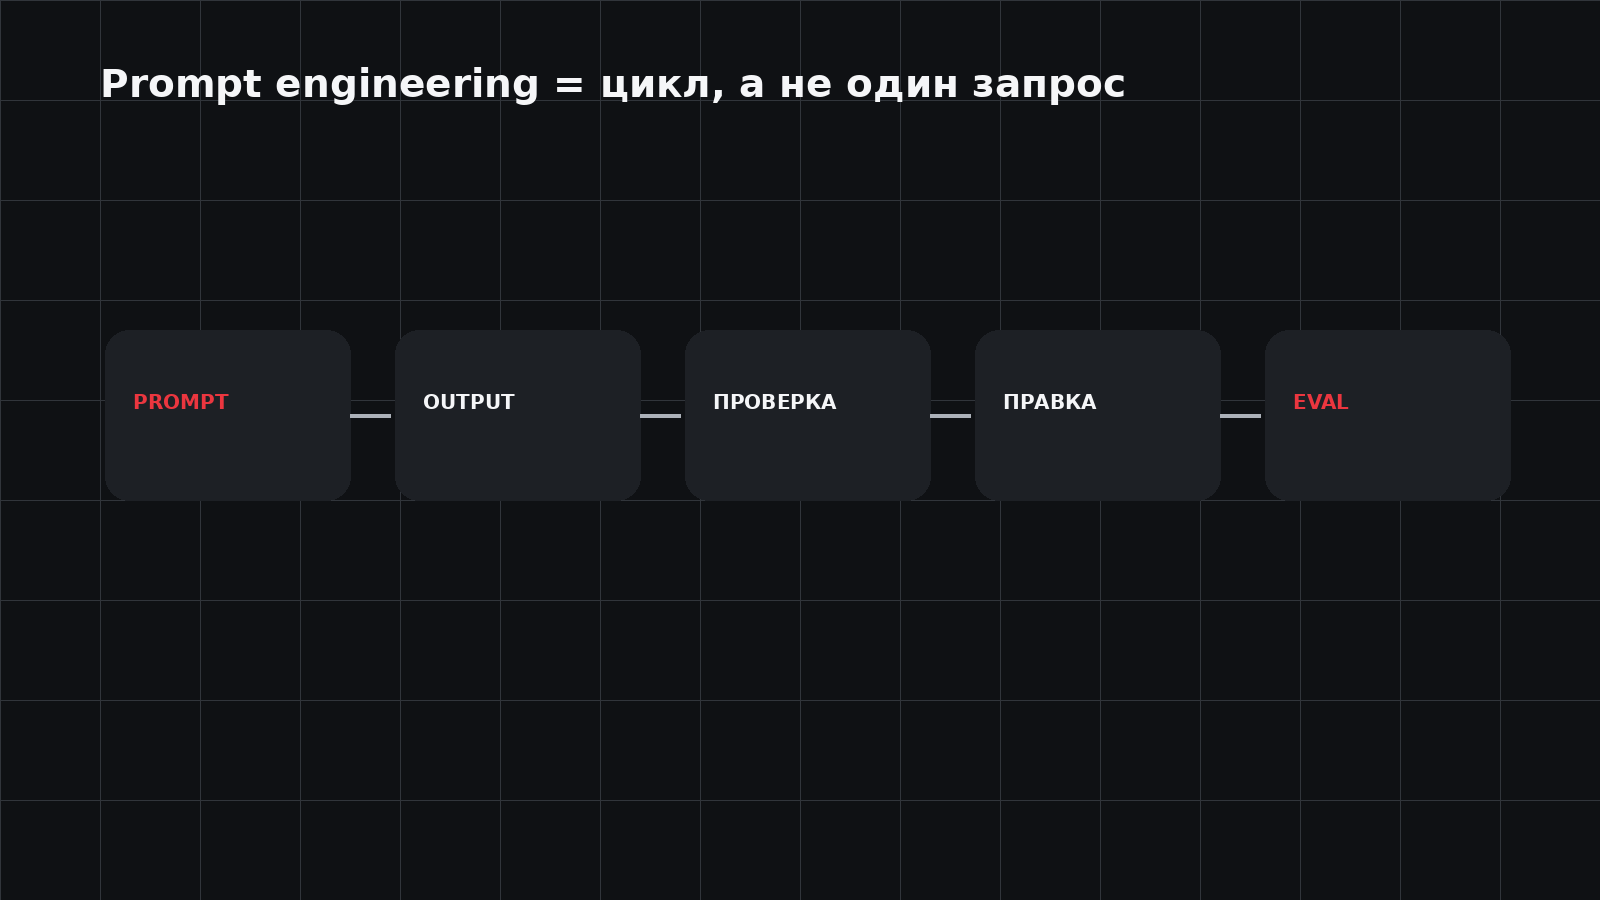
Prompt engineering как цикл
Первый prompt редко должен быть идеальным. OpenAI и Google прямо описывают prompting как итеративный процесс: создать запрос, посмотреть результат и уточнить его.
Практический цикл выглядит так: prompt → output → проверка → правка → повторный тест. Для повторяемых бизнес-задач добавляется eval set из нескольких типичных и сложных inputs.
Если prompt работает на одном красивом примере и ломается на остальных, это демонстрация, а не надёжный шаблон.
После обновления модели production prompt стоит перепроверить. Anthropic отдельно публикует migration considerations именно потому, что поведение моделей меняется.
Минимальный prompt
- Что нужно сделать?
- Какой контекст реально влияет на ответ?
- В каком виде нужен результат?
Для повторяемой рабочей задачи
- Добавьте variables и исходные данные.
- Опишите ограничения и критерии качества.
- Проверьте на нескольких разных inputs.
Для production
- Зафиксируйте target model и версию prompt.
- Создайте eval set и метрики.
- Перепроверяйте после заметных обновлений модели.
Итог
В 2026 году prompt engineering становится менее ритуальным и более инженерным. Сильный запрос не пытается «взломать» модель словами. Он точно описывает задачу, передаёт нужный контекст, задаёт границы и позволяет проверить результат.
Универсальная формула GPT House: цель → контекст → данные → ограничения → формат → критерий. Начните с минимальной версии, посмотрите output и усложняйте prompt только там, где это реально улучшает результат.
Источники
Вопросы и ответы
Какая формула промта самая универсальная?
Для большинства задач достаточно шести элементов: цель, контекст, данные, ограничения, формат и критерий качества. Использовать все шесть каждый раз не обязательно.
Нужно ли начинать prompt со слов «Ты эксперт»?
Нет. Роль полезна, когда задаёт нужную перспективу или тон, но важнее конкретная задача, контекст и критерии результата.
Чем длиннее промт, тем лучше?
Нет. Длина оправдана только полезным контекстом, данными, examples и ограничениями. Лишние инструкции могут создавать конфликт и шум.
Одинаково ли нужно писать для ChatGPT, Claude и Gemini?
Базовые принципы похожи, но сложные prompts лучше адаптировать под конкретную модель и её актуальную документацию.
Что делать, если нейросеть отвечает слишком общо?
Добавьте конкретные исходные данные, аудиторию, ограничения, желаемый output format и критерий хорошего результата.
Как понять, что prompt действительно хороший?
Проверьте его на нескольких реальных inputs. Хороший шаблон даёт стабильно полезный результат и требует предсказуемого объёма ручных правок.


